| title | Kakfa 面试 | |
|---|---|---|
| date | 2022-01-09 | |
| tags |
|
|
| categories | Interview |
Kafak 知识是对分布式,或者直接说是中间件、消息队列考察点的必问内容
- 解耦: 允许你独立的扩展或修改两边的处理过程,只要确保它们遵守同样的接口约束。
- 冗余:消息队列把数据进行持久化直到它们已经被完全处理,通过这一方式规避了数据丢失风险。许多消息队列所采用的"插入-获取-删除"范式中,在把一个消息从队列中删除之前,需要你的处理系统明确的指出该消息已经被处理完毕,从而确保你的数据被安全的保存直到你使用完毕。
- 扩展性: 因为消息队列解耦了你的处理过程,所以增大消息入队和处理的频率是很容易的,只要另外增加处理过程即可。
- 灵活性 & 峰值处理能力: 在访问量剧增的情况下,应用仍然需要继续发挥作用,但是这样的突发流量并不常见。 如果为以能处理这类峰值访问为标准来投入资源随时待命无疑是巨大的浪费。使用消息队列能够使关键组件顶住突发的访问压力,而不会因为突发的超负荷的请求而完全崩溃。
- 可恢复性: 系统的一部分组件失效时,不会影响到整个系统。消息队列降低了进程间的耦合度,所以即使一个处理消息的进程挂掉,加入队列中的消息仍然可以在系统恢复后被处理。
- 顺序保证: 在大多使用场景下,数据处理的顺序都很重要。大部分消息队列本来就是排序的,并且能保证数据会按照特定的顺序来处理。(Kafka 保证一个 Partition 内的消息的有序性)
- 缓冲: 有助于控制和优化数据流经过系统的速度, 解决生产消息和消费消息的处理速度不一致的情况。
- 异步通信: 很多时候,用户不想也不需要立即处理消息。消息队列提供了异步处理机制,允许用户把一个消息放入队列,但并不立即处理它。想向队列中放入多少消息就放多少,然后在需要的时候再去处理它们。
Kafka 是由 Apache 软件基金会开发的一个开源流处理平台。
Kafka 是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。
- 消息系统:解耦生产者和消费者、缓存消息等。
- 日志收集:一个公司可以用Kafka收集各种服务的log,通过kafka以统一接口服务的方式开放给各种consumer,例如hadoop、HBase、Solr等。
- 用户活动跟踪:Kafka经常被用来记录web用户或者app用户的各种活动,如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到kafka的topic中,然后订阅者通过订阅这些topic来做实时的监控分析,或者装载到hadoop、数据仓库中做离线分析和挖掘。
- 运营指标:Kafka也经常用来记录运营监控数据。包括收集各种分布式应用的数据,生产各种操作的集中反馈,比如报警和报告。
- 流式处理:比如spark streaming和 Flink
- 高吞吐量、低延迟:kafka 每秒可以处理几十万条消息,它的延迟最低只有几毫秒,每个 topic 可以分多个 partition, consumer group 对 partition 进行 consume 操作。
- 可扩展性:kafka 集群支持热扩展
- 持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失
- 容错性:允许集群中节点失败(若副本数量为n,则允许n-1个节点失败)
- 高并发:支持数千个客户端同时读写
- Producer API 允许应用程序发送数据流到 kafka 集群中的 topic
- Consumer API 允许应用程序从 kafka 集群的 topic 中读取数据流
- Streams API 允许从输入 topic 转换数据流到输出 topic
- Connect API 通过实现连接器(connector),不断地从一些源系统或应用程序中拉取数据到 kafka,或从 kafka 提交数据到宿系统(sink system)或应用程序
- Admin API 用于管理和检查 topic,broker 和其他 Kafka 对象
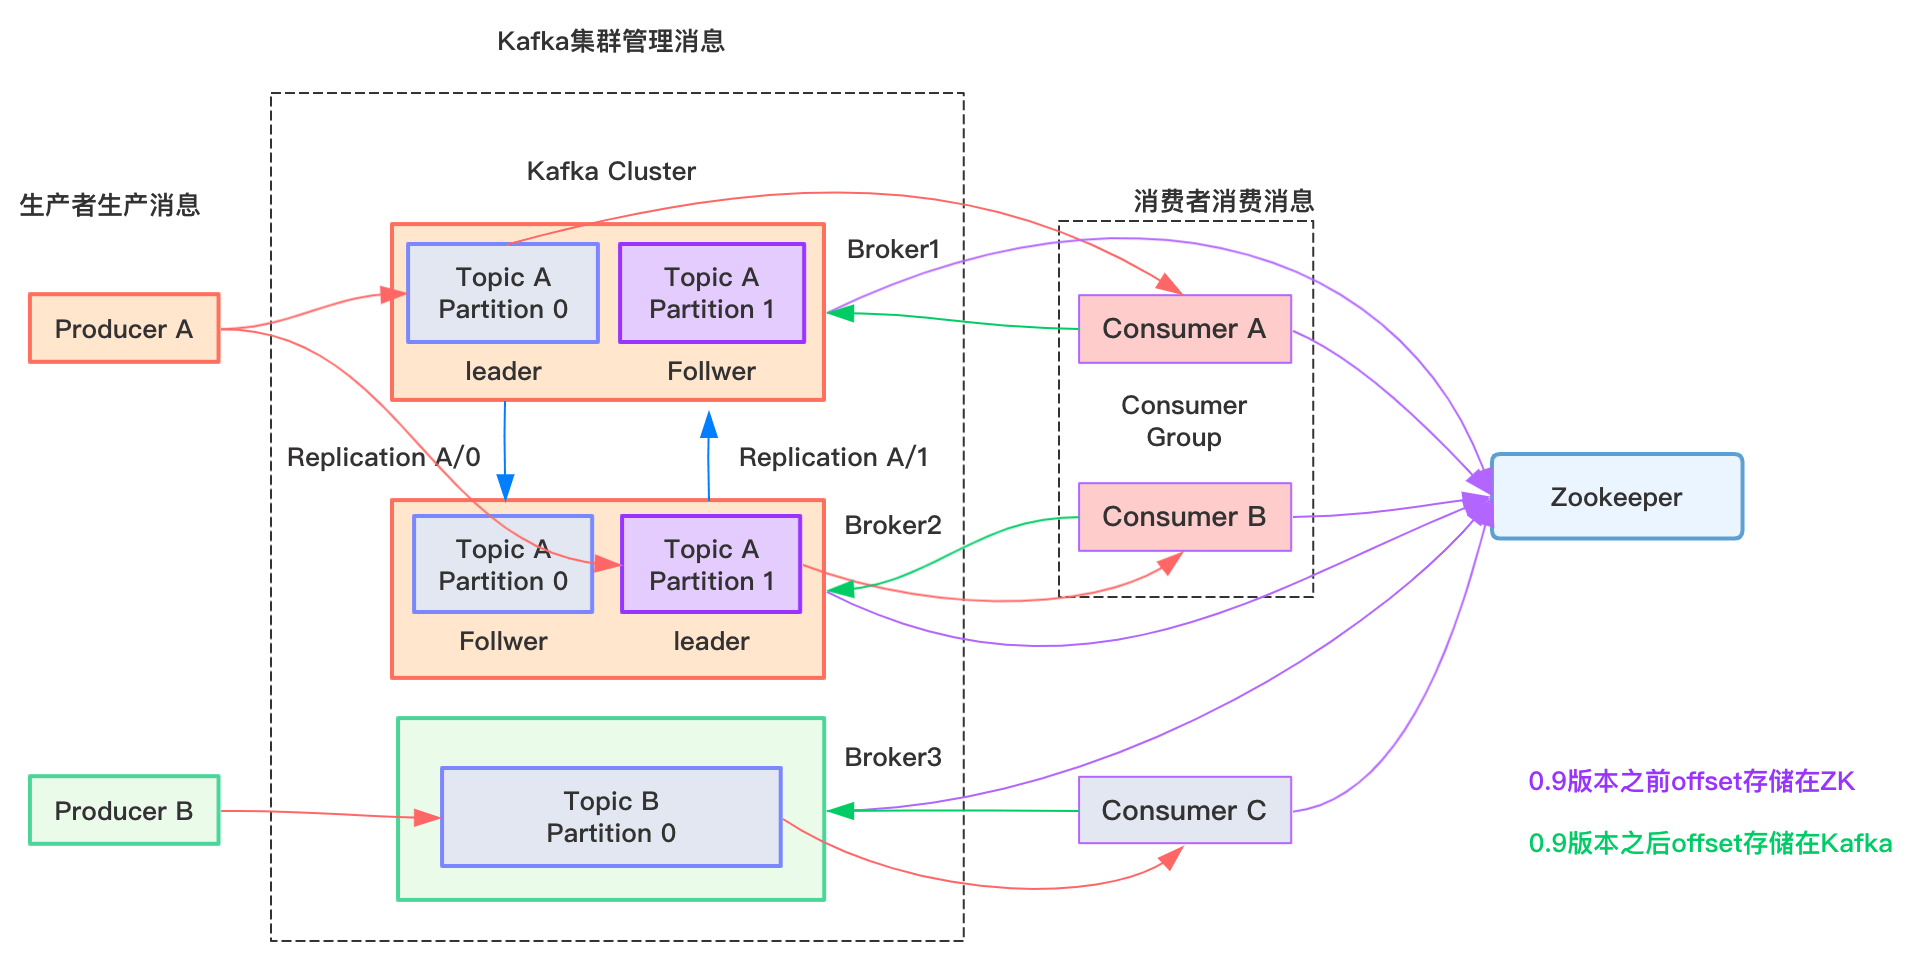
Kafka 架构分为以下几个部分
- Producer :消息生产者,就是向 kafka broker 发消息的客户端。
- Consumer :消息消费者,向 kafka broker 取消息的客户端。
- Topic :可以理解为一个队列,一个 Topic 又分为一个或多个分区。
- Consumer Group:这是 kafka 用来实现一个 topic 消息的广播(发给所有的 consumer)和单播(发给任意一个 consumer)的手段。一个 topic 可以有多个 Consumer Group。
- Broker :一台 kafka 服务就是一个 broker。一个集群由多个 broker 组成。一个 broker 可以容纳多个 topic。
- Partition:为了实现扩展性,一个非常大的 topic 可以分布到多个 broker上,每个 partition 是一个有序的队列。partition 中的每条消息都会被分配一个有序的 id(offset)。将消息发给 consumer,kafka 只保证按一个 partition 中的消息的顺序,不保证一个 topic 的整体(多个 partition 间)的顺序。
- Offset:kafka 的存储文件都是按照 offset.kafka 来命名,用 offset 做名字的好处是方便查找。例如你想找位于 2049 的位置,只要找到 2048.kafka 的文件即可。当然 the first offset 就是 00000000000.kafka。
Zookeeper 主要用于在集群中不同节点之间的通信
老版本的 kafka 中,偏移量信息也存放在 zk 中
在 Kafka 中,主要被用于 leader 检测、分布式同步、配置管理、识别新节点何时离开或者连接、集群、节点实时状态等
Kafka将元数据信息保存在Zookeeper中,但是发送给Topic本身的数据是不会发到Zk上的,否则Zk就疯了。kafka使用zookeeper来实现动态的集群扩展,不需要更改客户端(producer和consumer)的配置。broker会在zookeeper注册并保持相关的元数据(topic,partition信息等)更新。而客户端会在zookeeper上注册相关的watcher。一旦zookeeper发生变化,客户端能及时感知并作出相应调整。这样就保证了添加或去除broker时,各broker间仍能自动实现负载均衡。这里的客户端指的是Kafka的消息生产端(Producer)和消息消费端(Consumer)。Producer端使用zookeeper用来"发现"broker列表,以及和Topic下每个partition的leader建立socket连接并发送消息。也就是说每个Topic的partition是由Lead角色的Broker端使用zookeeper来注册broker信息,以及监测partition leader存活性.Consumer端使用zookeeper用来注册consumer信息,其中包括consumer消费的partition列表等,同时也用来发现broker列表,并和partition leader建立socket连接,并获取消息.
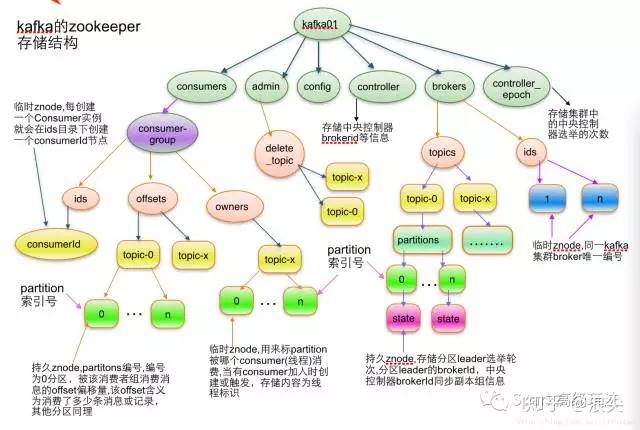
首先从controller看起,这是zk中一个重要的组成:Controller 作为 Kafka Server端一个重要的组件,它的角色类似于其他分布式系统Master的角色,跟其他系统不一样的是,Kafka集群的任何一台Broker都可以作为Controller,但是在一个集群中同时只会有一个 Controller是alive状态。在于分布式系统中,总会有一个地方需要对全局 meta 做一个统一的维护,Kafka 的 Controller 就是充当这个角色的。Controller 是运行在 Broker 上的,任何一台 Broker 都可以作为 Controller,但是一个集群同时只能存在一个 Controller,也就意味着 Controller 与数据节点是在一起的,Controller 做的主要事情如下:
Broker 的上线、下线处理; 新创建的 topic 或已有 topic 的分区扩容,处理分区副本的分配、leader 选举; 管理所有副本的状态机和分区的状态机,处理状态机的变化事件; topic 删除、副本迁移、leader 切换等处理。 Broker在启动时,会尝试去ZK创建/controller节点,第一个成功创建/controller节点的Broker会被指定为为控制器。了解了controller之后,通过一个图看在controller在zk整体中的情况:
controller就是zk中的一个节点,谁创建成功了谁就成为控制器,其他还有:
Broker注册:Broker在zookeeper中保存为一个临时节点,节点的路径是/brokers/ids/[brokerid],每个节点会保存对应broker的IP以及端口等信息.
Topic注册:在kafka中,一个topic会被分成多个区并被分到多个broker上,分区的信息以及broker的分布情况都保存在zookeeper中,根节点路径为/brokers/topics,每个topic都会在topics下建立独立的子节点,每个topic节点下都会包含分区以及broker的对应信息
partition状态信息:/brokers/topics/[topic]/partitions/[0…N] 其中[0…N]表示partition索引号
Controller epoch:此值为一个数字,kafka集群中第一个broker第一次启动时为1,以后只要集群中center controller中央控制器所在broker变更或挂掉,就会重新选举新的center controller,每次center controller变更controller_epoch值就会 + 1;
Controller注册信息:存储center controller中央控制器所在kafka broker的信息
生产者负载均衡:当Broker启动时,会注册该Broker的信息,以及可订阅的topic信息。生产者通过注册在Broker以及Topic上的watcher动态的感知Broker以及Topic的分区情况,从而将Topic的分区动态的分配到broker上.
消费者:kafka有消费者分组的概念,每个分组中可以包含多个消费者,每条消息只会发给分组中的一个消费者,且每个分组之间是相互独立互不影响的。Consumer注册信息: 每个consumer都有一个唯一的ID(consumerId可以通过配置文件指定,也可以由系统生成),此id用来标记消费者信息./consumers/[groupId]/ids/[consumerIdString]是一个临时的znode,此节点的值为请看consumerIdString产生规则,即表示此consumer目前所消费的topic + partitions列表.
消费者与分区的对应关系:对于每个消费者分组,kafka都会为其分配一个全局唯一的Group ID,分组内的所有消费者会共享该ID,kafka还会为每个消费者分配一个consumer ID,通常采用hostname:uuid的形式。在kafka的设计中规定,对于topic的每个分区,最多只能被一个消费者进行消费,也就是消费者与分区的关系是一对多的关系。消费者与分区的关系也被存储在zookeeper中节点的路劲为 /consumers/[group_id]/owners/[topic]/[broker_id-partition_id],该节点的内容就是消费者的Consumer ID
消费者负载均衡:消费者服务启动时,会创建一个属于消费者节点的临时节点,节点的路径为 /consumers/[group_id]/ids/[consumer_id],该节点的内容是该消费者订阅的Topic信息。每个消费者会对/consumers/[group_id]/ids节点注册Watcher监听器,一旦消费者的数量增加或减少就会触发消费者的负载均衡。消费者还会对/brokers/ids/[brokerid]节点进行监听,如果发现服务器的Broker服务器列表发生变化,也会进行消费者的负载均衡
- Kafka can now be used without ZooKeeper as of version 2.8. The release of Kafka 2.8.0 in April 2021 gave us all the opportunity to try it out without ZooKeeper. However, this version is not yet ready for production and lacks some key features.
- In the previous versions, bypassing Zookeeper and connecting directly to the Kafka broker was not possible. This is because when the Zookeeper is down, it is unable to fulfill client requests.
ZK 在kafka 集群中权重下降的原因
简而言之:负载均衡+水平扩展
Topic 只是逻辑概念,面向的是 producer 和 consumer;而 Partition 则是物理概念。
分区对于 Kafka 集群的好处是:实现负载均衡。分区对于消费者来说,可以提高并发度,提高效率。
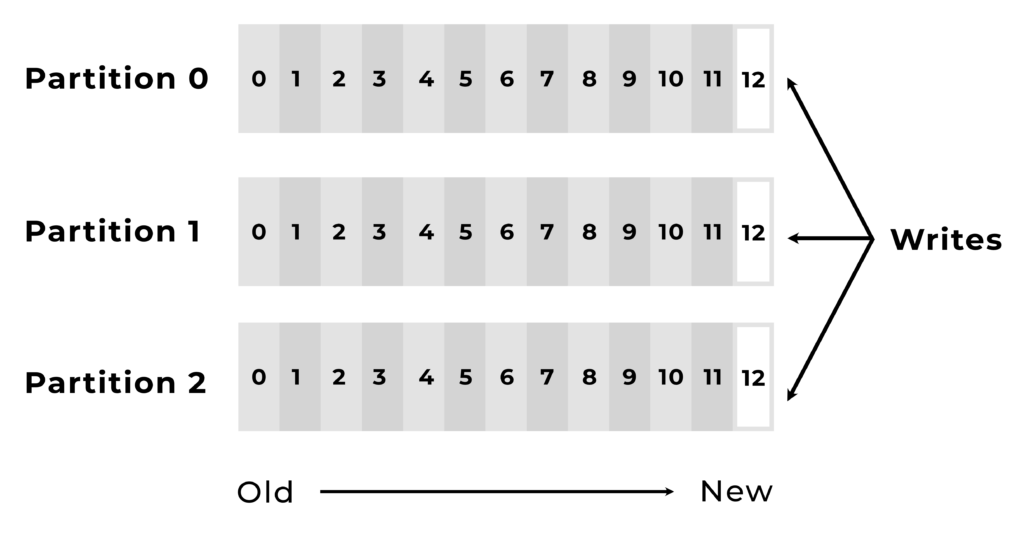
可以想象,如果 Topic 不进行分区,而将 Topic 内的消息存储于一个 broker,那么关于该 Topic 的所有读写请求都将由这一个 broker 处理,吞吐量很容易陷入瓶颈,这显然是不符合高吞吐量应用场景的。有了 Partition 概念以后,假设一个 Topic 被分为 10 个 Partitions,Kafka 会根据一定的算法将 10 个 Partition 尽可能均匀的分布到不同的 broker(服务器)上,当 producer 发布消息时,producer 客户端可以采用
random、key-hash及轮询等算法选定目标 partition,若不指定,Kafka 也将根据一定算法将其置于某一分区上。Partiton 机制可以极大的提高吞吐量,并且使得系统具备良好的水平扩展能力。
我们知道,在启动 Kafka 集群之前,我们需要配置好 log.dirs 参数,其值是 Kafka 数据的存放目录,这个参数可以配置多个目录,目录之间使用逗号分隔,通常这些目录是分布在不同的磁盘上用于提高读写性能。当然我们也可以配置 log.dir 参数,含义一样。只需要设置其中一个即可。
如果 log.dirs 参数只配置了一个目录,那么分配到各个 Broker 上的分区肯定只能在这个目录下创建文件夹用于存放数据。
但是如果 log.dirs 参数配置了多个目录,那么 Kafka 会在哪个文件夹中创建分区目录呢?答案是:Kafka 会在含有分区目录最少的文件夹中创建新的分区目录,分区目录名为 Topic名+分区ID。注意,是分区文件夹总数最少的目录,而不是磁盘使用量最少的目录!也就是说,如果你给 log.dirs 参数新增了一个新的磁盘,新的分区目录肯定是先在这个新的磁盘上创建直到这个新的磁盘目录拥有的分区目录不是最少为止。
答:如果就以 partition 为最小存储单位,可以想象,当 Kafka producer 不断发送消息,必然会引起 partition 文件的无限扩张,将对消息文件的维护以及已消费的消息的清理带来严重的影响,因此,需以 segment 为单位将 partition 进一步细分。每个 partition(目录)相当于一个巨型文件被平均分配到多个大小相等的 segment(段)数据文件中(每个 segment 文件中消息数量不一定相等)这种特性也方便 old segment 的删除,即方便已被消费的消息的清理,提高磁盘的利用率。每个 partition 只需要支持顺序读写就行,segment 的文件生命周期由服务端配置参数(log.segment.bytes,log.roll.{ms,hours} 等若干参数)决定。
答:segment 文件由两部分组成,分别为 “.index” 文件和 “.log” 文件,分别表示为 segment 索引文件和数据文件。这两个文件的命令规则为:partition 全局的第一个 segment 从 0 开始,后续每个 segment 文件名为上一个 segment 文件最后一条消息的 offset 值,数值大小为 64 位,20 位数字字符长度,没有数字用 0 填充
- Kafka 把 topic 中一个 parition 大文件分成多个小文件段,通过多个小文件段,就容易定期清除或删除已经消费完文件,减少磁盘占用。
- 通过索引信息可以快速定位 message 和确定 response 的最大大小。
- 通过 index 元数据全部映射到 memory,可以避免 segment file 的 IO 磁盘操作。
- 通过索引文件稀疏存储,可以大幅降低 index 文件元数据占用空间大小
producer 将消息推送到 broker,consumer 从 broker 拉取消息。
消费者采用 pull 的模式的好处就是消费速率可以自行控制,可以按自己的消费能力决定是否消费策略(是否批量等)
有个缺点是,如果没有消息可供消费是,consumer 也需要不断在循环中轮训等消息的到达,所以 kafka 为了避免这点,提供了阻塞式等新消息

- producer 先从 zookeeper 的 "/brokers/.../state"节点找到该 partition 的 leader
- producer 将消息发送给该 leader
- leader 将消息写入本地 log
- followers 从 leader pull 消息,写入本地 log 后向 leader 发送 ACK
- leader 收到所有 ISR 中的 replication 的 ACK 后,增加 HW(high watermark,最后 commit 的 offset)并向 producer 发送 ACK
Kafa consumer消费消息时,向broker发出fetch请求去消费特定分区的消息,consumer指定消息在日志中的偏移量(offset),就可以消费从这个位置开始的消息,customer拥有了offset的控制权,可以向后回滚去重新消费之前的消息,这是很有意义的
Consumer Group 是 Kafka 提供的可扩展且具有容错性的消费者机制。
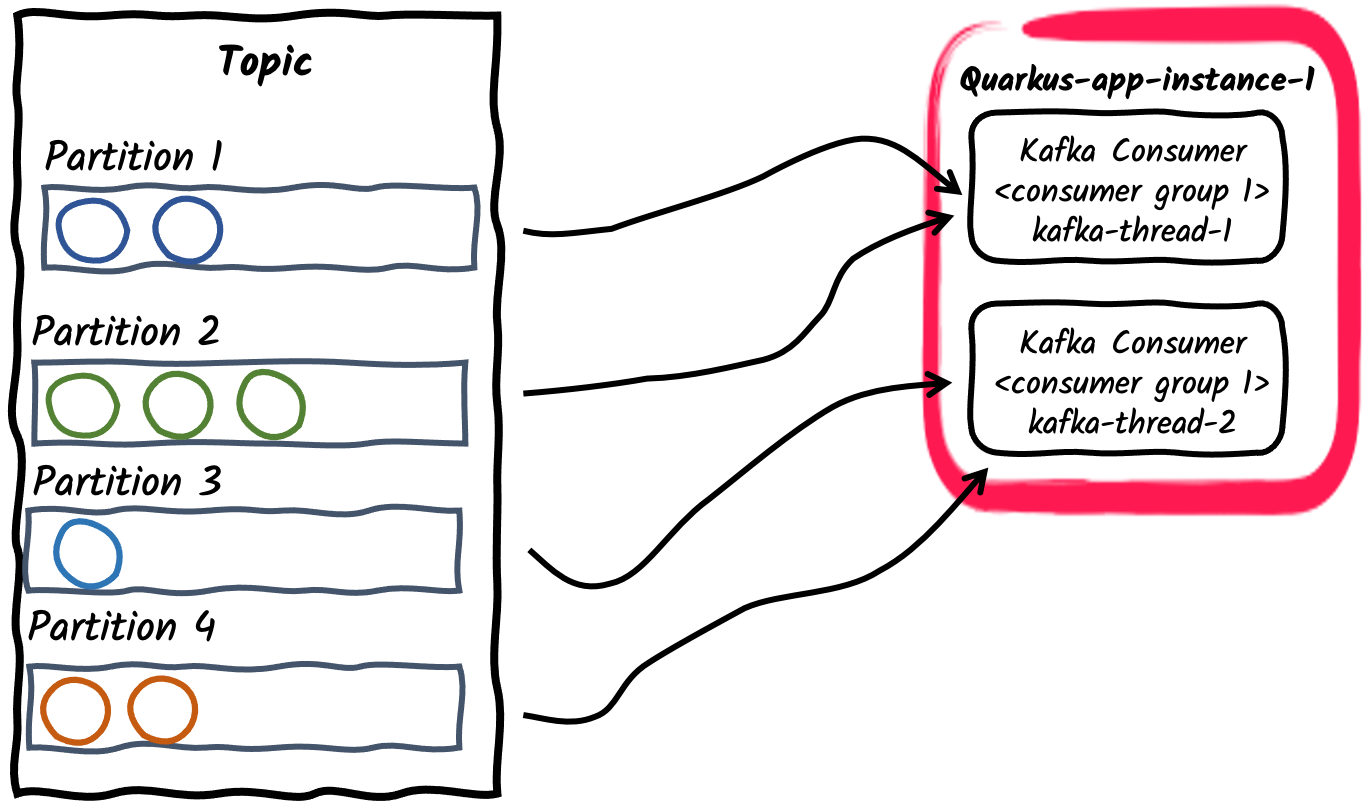
既然是一个组,那么组内必然可以有多个消费者或消费者实例(Consumer Instance),它们共享一个公共的 ID,这个 ID 被称为 Group ID。组内的所有消费者协调在一起来消费订阅主题(Subscribed Topics)的所有分区(Partition)。当然,每个分区只能由同一个消费者组内的一个 Consumer 实例来消费。
消费者组最为重要的一个功能是实现广播与单播的功能。一个消费者组可以确保其所订阅的 Topic 的每个分区只能被从属于该消费者组中的唯一一个消费者所消费;如果不同的消费者组订阅了同一个 Topic,那么这些消费者组之间是彼此独立的,不会受到相互的干扰。
所谓的副本机制(Replication),也可以称之为备份机制,通常是指分布式系统在多台网络互联的机器上保存有相同的数据拷贝。副本机制有什么好处呢?
- 提供数据冗余。即使系统部分组件失效,系统依然能够继续运转,因而增加了整体可用性以及数据持久性。
- 提供高伸缩性。支持横向扩展,能够通过增加机器的方式来提升读性能,进而提高读操作吞吐量。
- 改善数据局部性。允许将数据放入与用户地理位置相近的地方,从而降低系统延时。
Kafka 只是用副本机制来提供数据冗余实现高可用性和高持久性,也就是第一个好处
所谓副本,本质上就是一个只能追加写消息的提交日志。这些日志被相同的分散保存在不同的 Broker 上。
在实际生产上,每台 Broker 都可能保存有各个主题下不同分区的不同副本。因此单个Broker上存有成百上千个副本现象是非常正常的。
既然多个Broker中保存分区下的多个副本,那么是如何保证副本当中的数据都是一致的呢?
针对这个问题,kafka的解决方案就是领导者副本机制
- 在kafka中,副本分成两类:领导者副本和追随者副本。每个分区在创建时都要选举一个副本,成为领导者副本,其余的副本自动称为追随者副本。
- kafka中,追随者副本是不会对外提供服务的,所有的请求都必须由领导者副本来处理。它唯一的任务就是从领导者副本异步拉取消息,并写入到自己提交日志中,从而实现与领导者副本的同步。
- 当领导者副本挂掉了,或者说所在 Broker 宕机了,kafka 可以通过 Zookeeper 提供的监控功能能够实时感知到,并开启新一轮领导者选举,从追随者副本中选一个作为新的领导者。老 Leader 副本重启回来后,只能作为追随者副本加入到集群中。
方便实现“Read-your-writes”。
所谓 Read-your-writes,顾名思义就是,当你使用生产者 API 向 Kafka 成功写入消息后,马上使用消费者 API 去读取刚才生产的消息。
举个例子,比如你平时发微博时,你发完一条微博,肯定是希望能立即看到的,这就是典型的 Read-your-writes 场景。如果允许追随者副本对外提供服务,由于副本同步是异步的,因此有可能出现追随者副本还没有从领导者副本那里拉取到最新的消息,从而使得客户端看不到最新写入的消息。
方便实现单调读(Monotonic Reads)。
什么是单调读呢?就是对于一个消费者用户而言,在多次消费消息时,它不会看到某条消息一会儿存在一会儿不存在。
如果允许追随者副本提供读服务,那么假设当前有 2 个追随者副本 F1 和 F2,它们异步地拉取领导者副本数据。倘若 F1 拉取了 Leader 的最新消息而 F2 还未及时拉取,那么,此时如果有一个消费者先从 F1 读取消息之后又从 F2 拉取消息,它可能会看到这样的现象:第一次消费时看到的最新消息在第二次消费时不见了,这就不是单调读一致性。但是,如果所有的读请求都是由 Leader 来处理,那么 Kafka 就很容易实现单调读一致性。
- 节点必须可以维护和 ZooKeeper 的连接,Zookeeper 通过心跳机制检查每个节点的连接
- 如果节点是个 follower,他必须能及时的同步 leader 的写操作,延时不能太久,超时会被踢出 ISR
谈及可靠性,最常规、最有效的策略就是 “副本(replication)机制” ,Kafka 实现高可靠性同样采用了该策略。
通过调节副本相关参数,可使 Kafka 在性能和可靠性之间取得平衡。
实践中,我们为了保证 producer 发送的数据,能可靠地发送到指定的 topic,topic 的每个 partition 收到 producer 发送的数据后,都需要向 producer 发送 ack(acknowledge 确认收到),如果 producer 收到 ack,就会进行下一轮的发送,否则重新发送数据。
涉及到副本 ISR、故障处理中的 LEO、HW
一个 partition 有多个副本(replicas),为了提高可靠性,这些副本分散在不同的 broker 上,由于带宽、读写性能、网络延迟等因素,同一时刻,这些副本的状态通常是不一致的:即 followers 与 leader 的状态不一致。
为保证 producer 发送的数据,能可靠的发送到指定的 topic,topic 的每个 partition 收到 producer 数据后,都需要向 producer 发送 ack(acknowledgement确认收到),如果 producer 收到 ack,就会进行下一轮的发送,否则重新发送数据。
leader 维护了一个动态的 in-sync replica set(ISR),意为和 leader 保持同步的 follower 集合。当 ISR 中的 follower 完成数据的同步之后,leader 就会给 follower 发送 ack。
如果 follower 长时间未向 leader 同步数据,则该 follower 将会被踢出 ISR,该时间阈值由 replica.lag.time.max.ms 参数设定。当前默认值是 10 秒。这就是说,只要一个 follower 副本落后 Leader 副本的时间不连续超过 10 秒,那么 Kafka 就认为该 Follower 副本与 Leader 是同步的,即使此时 follower 副本中保存的消息明显少于 Leader 副本中的消息。
对于某些不太重要的数据,对数据的可靠性要求不是很高,能够容忍数据的少量丢失,所以没必要等 ISR 中的 follower 全部接收成功。
所以 Kafka 为用户提供了三种可靠性级别,用户根据对可靠性和延迟的要求进行权衡,选择以下的 acks 参数配置
- 0:producer 不等待 broker 的 ack,这一操作提供了一个最低的延迟,broker 一接收到还没有写入磁盘就已经返回,当 broker 故障时有可能丢失数据;
- 1:producer 等待 broker 的 ack,partition 的 leader 落盘成功后返回 ack,如果在 follower 同步成功之前 leader 故障,那么将会丢失数据;
- -1(all):producer 等待 broker 的 ack,partition 的 leader 和 follower 全部落盘成功后才返回 ack。但是如果在 follower 同步完成后,broker 发送 ack 之前,leader 发生故障,那么就会造成数据重复。
由于我们并不能保证 Kafka 集群中每时每刻 follower 的长度都和 leader 一致(即数据同步是有时延的),那么当 leader 挂掉选举某个 follower 为新的 leader 的时候(原先挂掉的 leader 恢复了成为了 follower),可能会出现 leader 的数据比 follower 还少的情况。为了解决这种数据量不一致带来的混乱情况,Kafka 提出了以下概念:
- LEO(Log End Offset):指的是每个副本最后一个offset;
- HW(High Wather):指的是消费者能见到的最大的 offset,ISR 队列中最小的 LEO。
消费者和 leader 通信时,只能消费 HW 之前的数据,HW 之后的数据对消费者不可见。
针对这个规则:
- 当follower发生故障时:follower 发生故障后会被临时踢出 ISR,待该 follower 恢复后,follower 会读取本地磁盘记录的上次的 HW,并将 log 文件高于 HW 的部分截取掉,从 HW 开始向 leader 进行同步。等该 follower 的 LEO 大于等于该 Partition 的 HW,即 follower 追上 leader 之后,就可以重新加入 ISR 了。
- 当leader发生故障时:leader 发生故障之后,会从 ISR 中选出一个新的 leader,之后,为保证多个副本之间的数据一致性,其余的 follower 会先将各自的 log 文件高于 HW 的部分截掉,然后从新的 leader 同步数据。
所以数据一致性并不能保证数据不丢失或者不重复,这是由 ack 控制的。HW 规则只能保证副本之间的数据一致性!
ISR:In-Sync Replicas 副本同步队列
OSR:Out-of-Sync Replicas
AR:Assigned Replicas 所有副本
ISR 是由 leader 维护,follower 从 leader 同步数据有一些延迟,超过相应的阈值会把 follower 剔除出 ISR,存入 OSR(Out-of-Sync Replicas )列表,新加入的 follower 也会先存放在 OSR 中。AR=ISR+OSR。
一致性就是说不论是老的 Leader 还是新选举的 Leader,Consumer 都能读到一样的数据。

假设分区的副本为3,其中副本0是 Leader,副本1和副本2是 follower,并且在 ISR 列表里面。虽然副本0已经写入了 Message4,但是 Consumer 只能读取到 Message2。因为所有的 ISR 都同步了 Message2,只有 High Water Mark 以上的消息才支持 Consumer 读取,而 High Water Mark 取决于 ISR 列表里面偏移量最小的分区,对应于上图的副本2,这个很类似于木桶原理。
这样做的原因是还没有被足够多副本复制的消息被认为是“不安全”的,如果 Leader 发生崩溃,另一个副本成为新 Leader,那么这些消息很可能丢失了。如果我们允许消费者读取这些消息,可能就会破坏一致性。试想,一个消费者从当前 Leader(副本0) 读取并处理了 Message4,这个时候 Leader 挂掉了,选举了副本1为新的 Leader,这时候另一个消费者再去从新的 Leader 读取消息,发现这个消息其实并不存在,这就导致了数据不一致性问题。
当然,引入了 High Water Mark 机制,会导致 Broker 间的消息复制因为某些原因变慢,那么消息到达消费者的时间也会随之变长(因为我们会先等待消息复制完毕)。延迟时间可以通过参数 replica.lag.time.max.ms 参数配置,它指定了副本在复制消息时可被允许的最大延迟时间。
数据传输的事务定义通常有以下三种级别:
- 最多一次: 消息不会被重复发送,最多被传输一次,但也有可能一次不传输
- 最少一次: 消息不会被漏发送,最少被传输一次,但也有可能被重复传输.
- 精确的一次(Exactly once): 不会漏传输也不会重复传输,每个消息都传输被
- 副本因子不能大于 Broker 的个数;
- 第一个分区(编号为0)的第一个副本放置位置是随机从
brokerList选择的; - 其他分区的第一个副本放置位置相对于第0个分区依次往后移。也就是如果我们有5个 Broker,5个分区,假设第一个分区放在第四个 Broker 上,那么第二个分区将会放在第五个 Broker 上;第三个分区将会放在第一个 Broker 上;第四个分区将会放在第二个 Broker 上,依次类推;
- 剩余的副本相对于第一个副本放置位置其实是由
nextReplicaShift决定的,而这个数也是随机产生的;
request.required.acks 有三个值 0、1、-1
- 0:
- 1:
- -1:
offset 提交机制
那面对“在使用 MQ 消息队列时,如何确保消息不丢失”这个问题时,你要怎么回答呢?首先,你要分析其中有几个考点,比如:
-
如何知道有消息丢失?
-
哪些环节可能丢消息?
-
如何确保消息不丢失?
Kafka 只对“已提交”的消息(committed message)做有限度的持久化保证。
一条消息从生产到消费完成这个过程,可以划分三个阶段
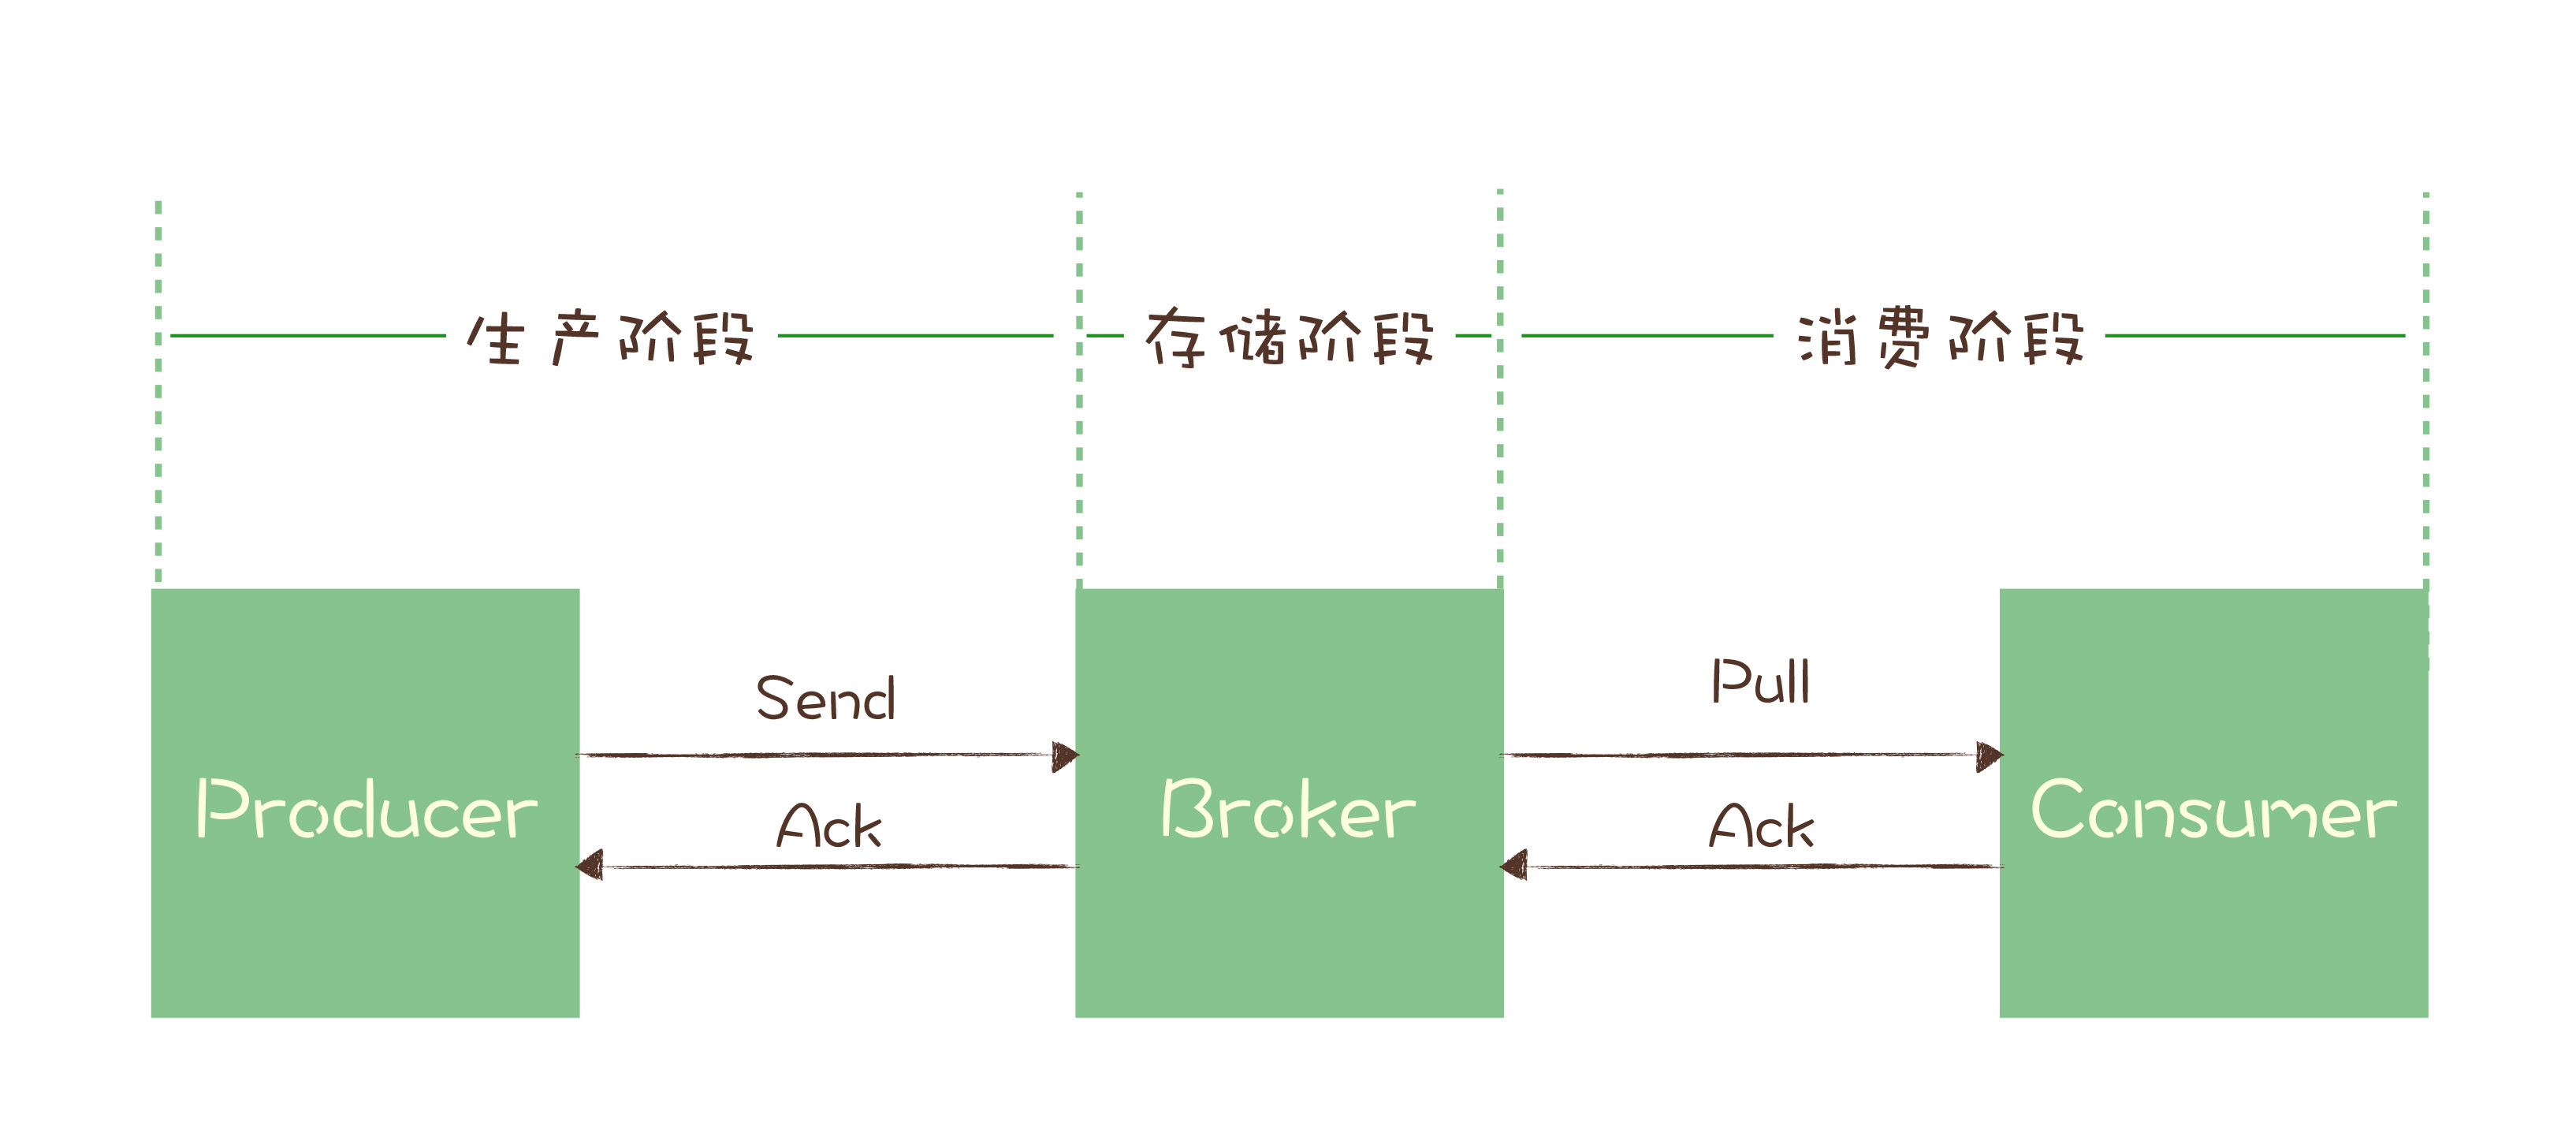
可能会有哪些因素导致消息没有发送成功呢?其实原因有很多,例如网络抖动,导致消息压根就没有发送到 Broker 端;或者消息本身不合格导致 Broker 拒绝接收(比如消息太大了,超过了 Broker 的承受能力)等
解决此问题的方法非常简单:Producer 永远要使用带有回调通知的发送 API,也就是说不要使用 producer.send(msg),而要使用 producer.send(msg, callback)。不要小瞧这里的 callback(回调),它能准确地告诉你消息是否真的提交成功了。一旦出现消息提交失败的情况,你就可以有针对性地进行处理。
在存储阶段正常情况下,只要 Broker 在正常运行,就不会出现丢失消息的问题,但是如果 Broker 出现了故障,比如进程死掉了或者服务器宕机了,还是可能会丢失消息的。
所以 Broker 会做副本,保证一条消息至少同步两个节点再返回 ack
Consumer 端丢失数据主要体现在 Consumer 端要消费的消息不见了。Consumer 程序有个“位移”的概念,表示的是这个 Consumer 当前消费到的 Topic 分区的位置。下面这张图清晰地展示了 Consumer 端的位移数据。
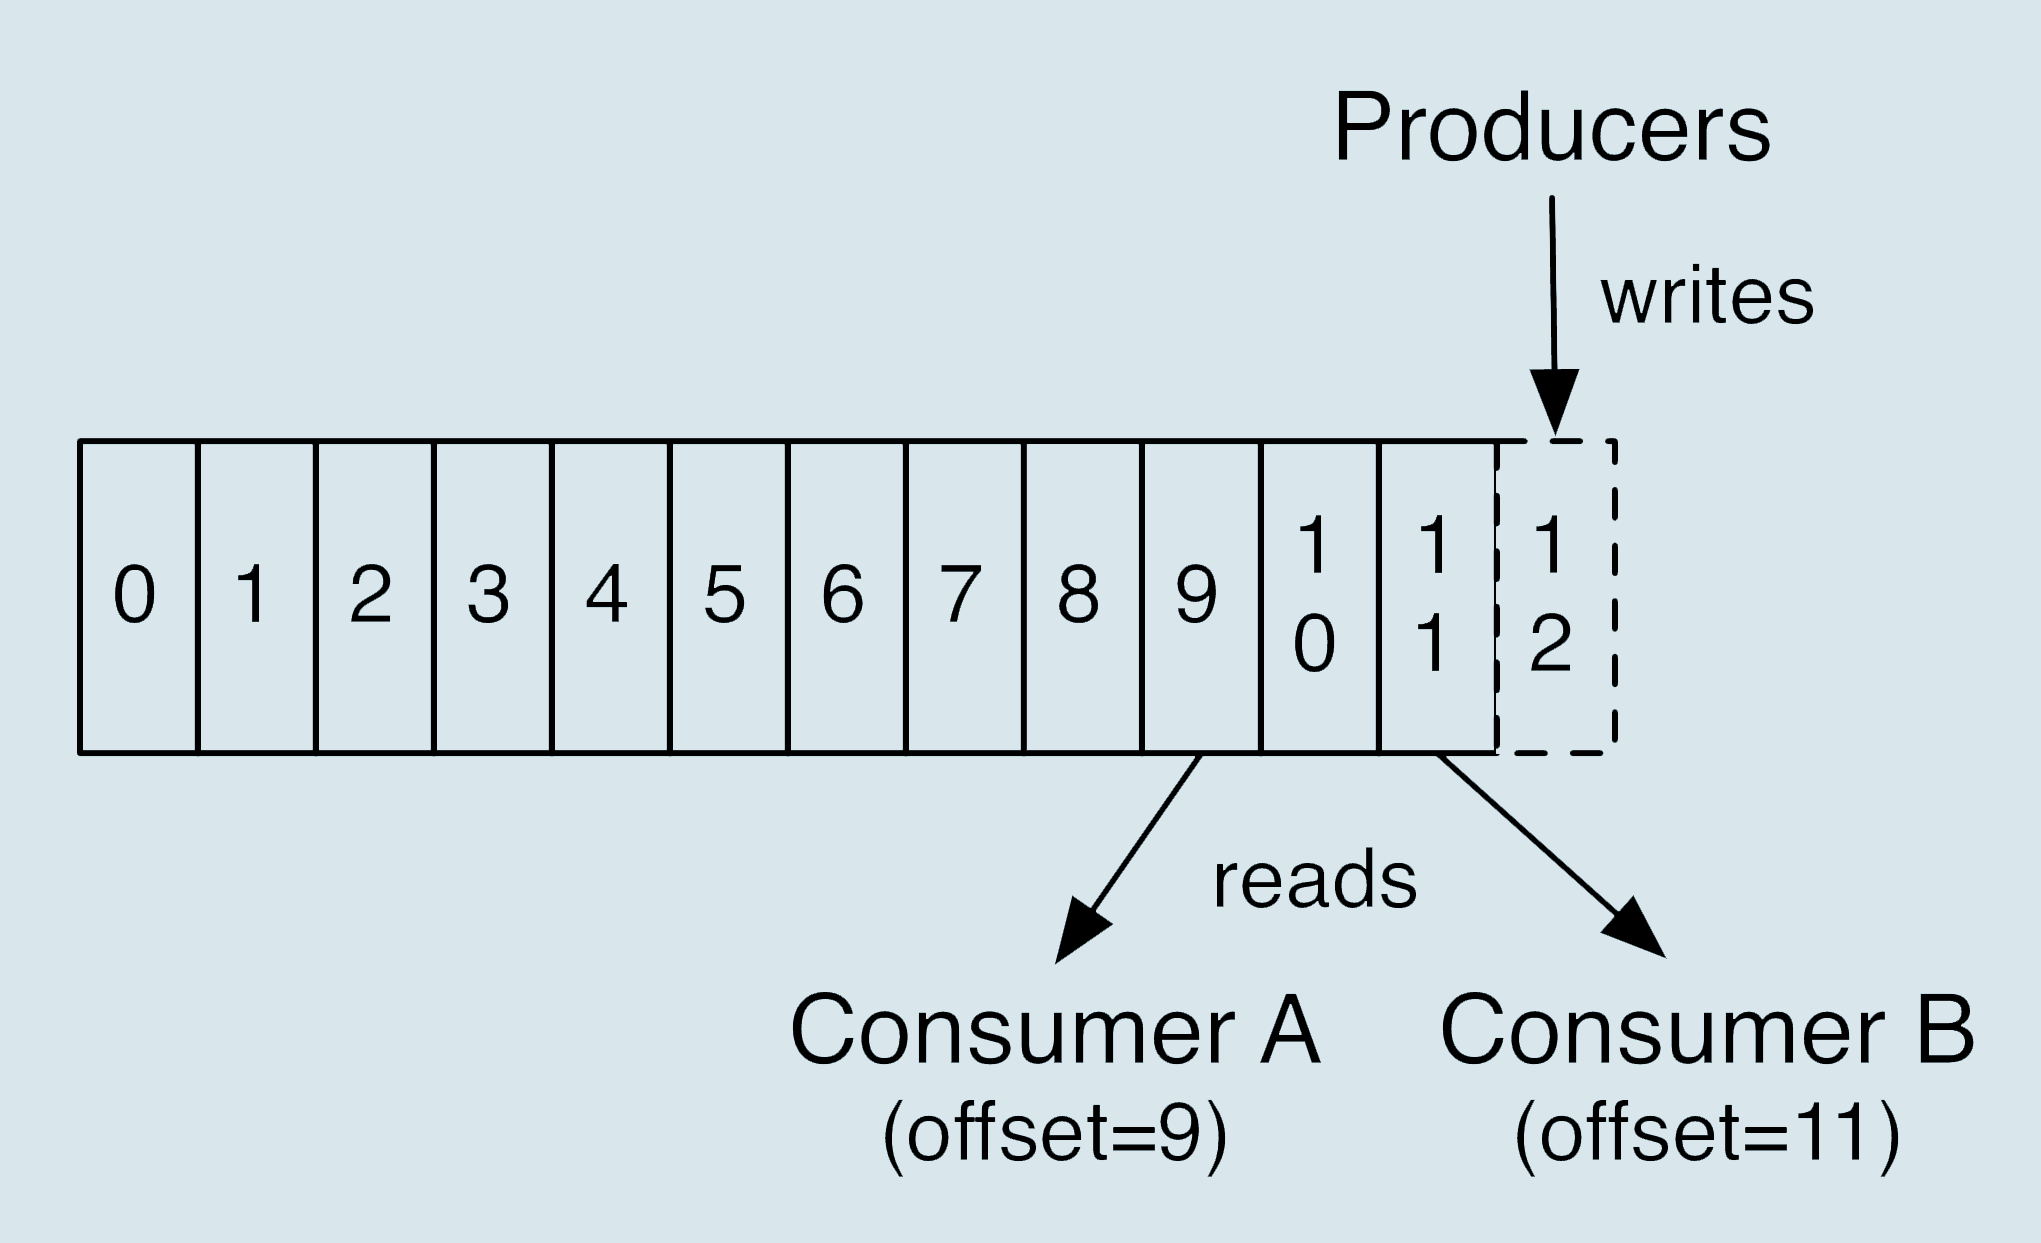
比如对于 Consumer A 而言,它当前的位移值就是 9;Consumer B 的位移值是 11。
这里的“位移”类似于我们看书时使用的书签,它会标记我们当前阅读了多少页,下次翻书的时候我们能直接跳到书签页继续阅读。
正确使用书签有两个步骤:第一步是读书,第二步是更新书签页。如果这两步的顺序颠倒了,就可能出现这样的场景:当前的书签页是第 90 页,我先将书签放到第 100 页上,之后开始读书。当阅读到第 95 页时,我临时有事中止了阅读。那么问题来了,当我下次直接跳到书签页阅读时,我就丢失了第 96~99 页的内容,即这些消息就丢失了。
同理,Kafka 中 Consumer 端的消息丢失就是这么一回事。要对抗这种消息丢失,办法很简单:维持先消费消息(阅读),再更新位移(书签)的顺序即可。这样就能最大限度地保证消息不丢失。
当然,这种处理方式可能带来的问题是消息的重复处理,类似于同一页书被读了很多遍,但这不属于消息丢失的情形。
如果是多线程异步处理消费消息,Consumer 程序不要开启自动提交位移,而是要应用程序手动提交位移。
- 不要使用 producer.send(msg),而要使用 producer.send(msg, callback)。记住,一定要使用带有回调通知的 send 方法。
- 设置
acks = all。acks 是 Producer 的一个参数,代表了你对“已提交”消息的定义。如果设置成 all,则表明所有副本 Broker 都要接收到消息,该消息才算是“已提交”。这是最高等级的“已提交”定义。 - 设置 retries 为一个较大的值。这里的 retries 同样是 Producer 的参数,对应前面提到的 Producer 自动重试。当出现网络的瞬时抖动时,消息发送可能会失败,此时配置了 retries > 0 的 Producer 能够自动重试消息发送,避免消息丢失。
- 设置参数
retry.backoff.ms。指消息生产超时或失败后重试的间隔时间,单位是毫秒。如果重试时间太短,会出现系统还没恢复就开始重试的情况,进而导致再次失败。300 毫秒算是比较合适的。 - 设置
unclean.leader.election.enable = false。这是 Broker 端的参数,指是否能把非 ISR 集合中的副本选举为 leader 副本。unclean.leader.election.enable = true,也就是说允许非 ISR 集合中的 follower 副本成为 leader 副本。如果一个 Broker 落后原先的 Leader 太多,那么它一旦成为新的 Leader,必然会造成消息的丢失。故一般都要将该参数设置成 false,即不允许这种情况的发生。 - 设置
replication.factor >= 3。这也是 Broker 端的参数,表示分区副本的个数。其实这里想表述的是,最好将消息多保存几份,毕竟目前防止消息丢失的主要机制就是冗余。 - 设置
min.insync.replicas > 1。这依然是 Broker 端参数,指的是 ISR 最少的副本数量。在实际环境中千万不要使用默认值 1。 - 确保 replication.factor > min.insync.replicas。如果两者相等,那么只要有一个副本挂机,整个分区就无法正常工作了。我们不仅要改善消息的持久性,防止数据丢失,还要在不降低可用性的基础上完成。推荐设置成 replication.factor = min.insync.replicas + 1。
- 确保消息消费完成再提交。Consumer 端有个参数
enable.auto.commit,最好把它设置成 false,并采用手动提交位移的方式。如果把参数 enable.auto.commit 设置为 true 就表示消息偏移量是由消费端自动提交,由异步线程去完成的,业务线程无法控制。如果刚拉取了消息之后,业务处理还没进行完,这时提交了消息偏移量但是消费者却挂了,这就造成还没进行完业务处理的消息的位移被提交了,下次再消费就消费不到这些消息,造成消息的丢失。
相关设置
- Producer:ack, retry
- Broker: replica、min_isr、unclen.electron、log.flush.messages
- Consumer: offset_commit
Kafka 又是如何做到消息不重复的,也就是:生产端不重复生产消息,服务端不重复存储消息,消费端也不能重复消费消息。
相较上面“消息不丢失”的场景,“消息不重复”的服务端无须做特别的配置,因为服务端不会重复存储消息,如果有重复消息也应该是由生产端重复发送造成的。
生产端发送消息后,服务端已经收到消息了,但是假如遇到网络问题,无法获得响应,生产端就无法判断该消息是否成功提交到了 Kafka,而我们一般会配置重试次数,但这样会引发生产端重新发送同一条消息,从而造成消息重复的发送。
对于这个问题,Kafka 0.11.0 的版本之前并没有什么解决方案,不过从 0.11.0 的版本开始,Kafka 给每个生产端生成一个唯一的 ID,并且在每条消息中生成一个 sequence num,sequence num 是递增且唯一的,这样就能对消息去重,达到一个生产端不重复发送一条消息的目的。
但是这个方法是有局限性的,只对在一个生产端内生产的消息有效,如果一个消息分别在两个生产端发送就不行了,还是会造成消息的重复发送。好在这种可能性比较小,因为消息的重试一般会在一个生产端内进行。当然,对应一个消息分别在两个生产端发送的请求我们也有方案,只是要多做一些补偿的工作,比如,我们可以为每一个消息分配一个全局 ID,并把全局 ID 存放在远程缓存或关系型数据库里,这样在发送前可以判断一下是否已经发送过了。
保证消息队列的幂等性的方案?
- 向数据库insert数据时,先根据主键查询,若数据存在则不insert,改为update
- 向Redis中写数据可以用set去重,天然保证幂等性
- 生产者发送每条消息时,增加一个全局唯一id(类似订单id),消费者消费到时,先根据这个id去Redis中查询是否消费过该消息。如果没有消费过,就处理,将id写入Redis;如果消费过了,那么就不处理,保证不重复处理相同消息。
- 基于数据库的唯一键约束来保证不会插入重复的数据,当消费者企图插入重复数据到数据库时,会报错。
为了保证消息不重复,消费端就不能重复消费消息,该如何去实现呢?消费端需要做好如下配置。
第一步,设置 enable.auto.commit=false。跟前面一样,这里同样要避免自动提交偏移量。你可以想象这样一种情况,消费端拉取消息和处理消息都完成了,但是自动提交偏移量还没提交消费端却挂了,这时候 Kafka 消费组开始重新平衡并把分区分给另一个消费者,由于偏移量没提交新的消费者会重复拉取消息,这就最终造成重复消费消息。
第二步,单纯配成手动提交同样不能避免重复消费,还需要消费端使用正确的消费“姿势”。这里还是先看下图这种情况:

消费者拉取消息后,先提交 offset 后再处理消息,这样就不会出现重复消费消息的可能。但是你可以想象这样一个场景:在提交 offset 之后、业务逻辑处理消息之前出现了宕机,待消费者重新上线时,就无法读到刚刚已经提交而未处理的这部分消息(这里对应图中 5~8 这部分消息),还是会有少消费消息的情况。
List<String> messages = consumer.poll();
consumer.commitOffset();
processMsg(messages);-
1 个 Topic 只创建 1 个Partition(分区),这样生产者的所有数据都发送到了一个 Partition,保证了消息的消费顺序(这样的坏处就是磨灭了 kafka 最优秀的特性。所以可以思考下是不是技术选型有问题, kafka本身适合与流式大数据量,要求高吞吐,对数据有序性要求不严格的场景。
-
生产者在发送消息的时候指定要发送到哪个 Partition
怎么指定呢?我们需要将 producer 发送的数据封装成一个 ProducerRecord 对象。
-
指明 partition 的情况下,直接将指明的值作为 partiton 值;
-
没有指明 partition 值但有 key 的情况下,将 key 的 hash 值与 topic 的 partition数进行取余得到 partition 值;
在 Producer 往 Kafka 插入数据时,控制同一Key分发到同一 Partition,并且设置参数
max.in.flight.requests.per.connection=1,也即同一个链接只能发送一条消息,如此便可严格保证 Kafka 消息的顺序 -
既没有 partition 值又没有 key 值的情况下,第一次调用时随机生成一个整数(后面每次调用在这个整数上自增),将这个值与 topic 可用的 partition 总数取余得到 partition 值,也就是常说的 round-robin 算法。
-
如果出现积压,那一定是性能问题,想要解决消息从生产到消费上的性能问题,就首先要知道哪些环节可能出现消息积压,然后在考虑如何解决。
因为消息发送之后才会出现积压的问题,所以和消息生产端没有关系,又因为绝大部分的消息队列单节点都能达到每秒钟几万的处理能力,相对于业务逻辑来说,性能不会出现在中间件的消息存储上面。毫无疑问,出问题的肯定是消息消费阶段,那么从消费端入手,如何回答呢?
水平扩容
消费端的性能优化除了优化消费业务逻辑以外,也可以通过水平扩容,增加消费端的并发数来提升总体的消费性能。特别需要注意的一点是,**在扩容 Consumer 的实例数量的同时,必须同步扩容主题中的分区(也叫队列)数量,确保 Consumer 的实例数和分区数量是相等的。**如果 Consumer 的实例数量超过分区数量,这样的扩容实际上是没有效果的。原因我们之前讲过,因为对于消费者来说,在每个分区上实际上只能支持单线程消费。
如果是线上突发问题,要临时扩容,增加消费端的数量,与此同时,降级一些非核心的业务。通过扩容和降级承担流量,这是为了表明你对应急问题的处理能力。
其次,才是排查解决异常问题,如通过监控,日志等手段分析是否消费端的业务逻辑代码出现了问题,优化消费端的业务处理逻辑。
最后,如果是消费端的处理能力不足,可以通过水平扩容来提供消费端的并发处理能力,但这里有一个考点需要特别注意, 那就是在扩容消费者的实例数的同时,必须同步扩容主题 Topic 的分区数量,确保消费者的实例数和分区数相等。如果消费者的实例数超过了分区数,由于分区是单线程消费,所以这样的扩容就没有效果。
比如在 Kafka 中,一个 Topic 可以配置多个 Partition(分区),数据会被写入到多个分区中,但在消费的时候,Kafka 约定一个分区只能被一个消费者消费,Topic 的分区数量决定了消费的能力,所以,可以通过增加分区来提高消费者的处理能力。
Rebalance 本质上是一种协议,主要作用是为了保证消费者组(Consumer Group)下的所有消费者(Consumer)消费的主体分区达成均衡。
比如:我们有10个分区,当我们有一个消费者时,该消费者消费10个分区,当我们增加一个消费者,理论上每个消费者消费5个分区,这个分配的过程我们成为Rebalance(重平衡)触发条件
常见的有三种情况会触发Rebalance:
- 组成员发生变更(新consumer加入组、已有consumer主动离开组或已有consumer崩溃了)
- 订阅主题数发生变更,如果你使用了正则表达式的方式进行订阅,那么新建匹配正则表达式的topic就会触发rebalance
- 订阅主题的分区数发生变更
缺点
- Rebalance时所有消费者无法消费数据
- Rebalance速度慢
- Rebalance 效率不高
Rebalance的过程如下:
和旧版本consumer依托于Zookeeper进行rebalance不同,新版本consumer使用了Kafka内置的一个全新的组协调协议(group coordination protocol)。
对于每个组而言,Kafka的某个broker会被选举为组协调者(group coordinator)。
Kafka新版本 consumer 默认提供了 3 种分配策略,分别是 range 策略、round-robin 策略和 sticky 策略
-
所有成员都向 coordinator 发送请求,请求入组。一旦所有成员都发送了请求,coordinator 会从中选择一个consumer 担任 leader 的角色,并把组成员信息以及订阅信息发给 leader。
-
leader 开始分配消费方案,指明具体哪个 consumer 负责消费哪些 topic 的哪些 partition。一旦完成分配,leader 会将这个方案发给 coordinator。coordinator 接收到分配方案之后会把方案发给各个 consumer,这样组内的所有成员就都知道自己应该消费哪些分区了。
每天两三亿数据量,每秒几千条,设置多少分区合适
根据集群的机器数量和需要的吞吐量来决定适合的分区数
- partition 并行处理
- 顺序写磁盘,充分利用磁盘特性
- 利用了现代操作系统分页存储 Page Cache 来利用内存提高 I/O 效率
- 采用了零拷贝技术
- Producer 生产的数据持久化到 broker,采用 mmap 文件映射,实现顺序的快速写入
- Customer 从 broker 读取数据,采用 sendfile,将磁盘文件读到 OS 内核缓冲区后,转到 NIO buffer进行网络发送,减少 CPU 消耗
By default, the maximum size of a Kafka message is 1MB (megabyte). The broker settings allow you to modify the size. Kafka, on the other hand, is designed to handle 1KB messages as well.
- 不能减少
__consumer_offsets 以下划线开头,保存消费组的偏移
在 Kafka 中,生产者写入消息、消费者读取消息的操作都是与 leader 副本进行交互的,从 而实现的是一种主写主读的生产消费模型。
Kafka 并不支持主写从读,因为主写从读有 2 个很明 显的缺点:
(1)数据一致性问题。数据从主节点转到从节点必然会有一个延时的时间窗口,这个时间 窗口会导致主从节点之间的数据不一致。某一时刻,在主节点和从节点中 A 数据的值都为 X, 之后将主节点中 A 的值修改为 Y,那么在这个变更通知到从节点之前,应用读取从节点中的 A 数据的值并不为最新的 Y,由此便产生了数据不一致的问题。
(2)延时问题。类似 Redis 这种组件,数据从写入主节点到同步至从节点中的过程需要经 历网络→主节点内存→网络→从节点内存这几个阶段,整个过程会耗费一定的时间。而在 Kafka 中,主从同步会比 Redis 更加耗时,它需要经历网络→主节点内存→主节点磁盘→网络→从节 点内存→从节点磁盘这几个阶段。对延时敏感的应用而言,主写从读的功能并不太适用。
其实回答这类问题,说白了,起码不求你看过那技术的源码,起码你大概知道那个技术的基本原理,核心组成部分,基本架构构成,然后参照一些开源的技术把一个系统设计出来的思路说一下就好
比如说这个消息队列系统,我们来从以下几个角度来考虑一下
(1)首先这个mq得支持可伸缩性吧,就是需要的时候快速扩容,就可以增加吞吐量和容量,那怎么搞?设计个分布式的系统呗,参照一下kafka的设计理念,broker -> topic -> partition,每个partition放一个机器,就存一部分数据。如果现在资源不够了,简单啊,给topic增加partition,然后做数据迁移,增加机器,不就可以存放更多数据,提供更高的吞吐量了?
(2)其次你得考虑一下这个mq的数据要不要落地磁盘吧?那肯定要了,落磁盘,才能保证别进程挂了数据就丢了。那落磁盘的时候怎么落啊?顺序写,这样就没有磁盘随机读写的寻址开销,磁盘顺序读写的性能是很高的,这就是kafka的思路。
(3)其次你考虑一下你的mq的可用性啊?这个事儿,具体参考我们之前可用性那个环节讲解的kafka的高可用保障机制。多副本 -> leader & follower -> broker挂了重新选举leader即可对外服务。
(4)能不能支持数据0丢失啊?可以的,参考我们之前说的那个kafka数据零丢失方案
其实一个mq肯定是很复杂的,其实这是个开放题,就是看看你有没有从架构角度整体构思和设计的思维以及能力。