面试必问的数据结构内容也比较多,分块整理一下 ,先学习树
树是一种数据结构,它是由n(n>=0)个有限节点组成一个具有层次关系的集合,存储的是具有“一对多”关系的数据元素的集合。把它叫做“树”是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的
- 除根节点之外的节点被划分为非空集,其中每个节点将被称为子树
- 树的节点要么保持它们之间的父子关系,要么它们是姐妹节点
- 在通用树中,一个节点可以具有任意数量的子节点,但它只能有一个父节点
- 下图显示了一棵树,其中节点
A是树的根节点,而其他节点可以看作是A的子节点

- 根节点 : 树中最顶端的节点,根没有父节点
- 子树: 如果根节点不为空,则树
T1,T2和T3称为根节点的子树。 - 父节点(Parent):如果节点拥有子节点,则该节点为子节点的父节点。
- 叶节点:没有子节点的节点,是树的末端节点。
- 路径: 连续边的序列称为路径。 在上图所示的树中,节点
E的路径为A→B→E。 - 祖先节点: 节点的祖先是从根到该节点的路径上的任何前节点。根节点没有祖先节点。 在上图所示的树中,节点
F的祖先是B和A。 - 度: 节点的度数等于子节点数。 在上图所示的树中,节点
B的度数为2。叶子节点的度数总是0,而在完整的二叉树中,每个节点的度数等于2。 - 边(Edge):两个节点中间的链接。
- 高度(Height)/深度(Depth):树中层的数量。比如只有 Level 0,Level 1,Level 2 则高度为 3。
- 级别编号: 为树的每个节点分配一个级别编号,使得每个节点都存在于高于其父级的一个级别。树的根节点始终是级别
0。 - 层级(Level):根为 Level 0 层,根的子节点为 Level 1 层,以此类推。
- 有序树、无序树:如果将树中的各个子树看成是从左到右是有次序的,则称该树是有序树;若不考虑子树的顺序称为无序树。
- 森林:m(m>=0)棵互不交互的树的集合。对树中每个结点而言,其子树的集合即为森林。
遍历的含义就是把树的所有节点(Node)按照某种顺序访问一遍。包括前序,中序,后续,广度优先(队列),深度优先(栈)5种遍历方法
| 遍历方法 | 顺序 | 示意图 | 顺序 | 应用 |
|---|---|---|---|---|
| 前序 | 根 ➜ 左 ➜ 右 |  |
12457836 | 想在节点上直接执行操作(或输出结果)使用先序 |
| 中序 | 左 ➜ 根 ➜ 右 | 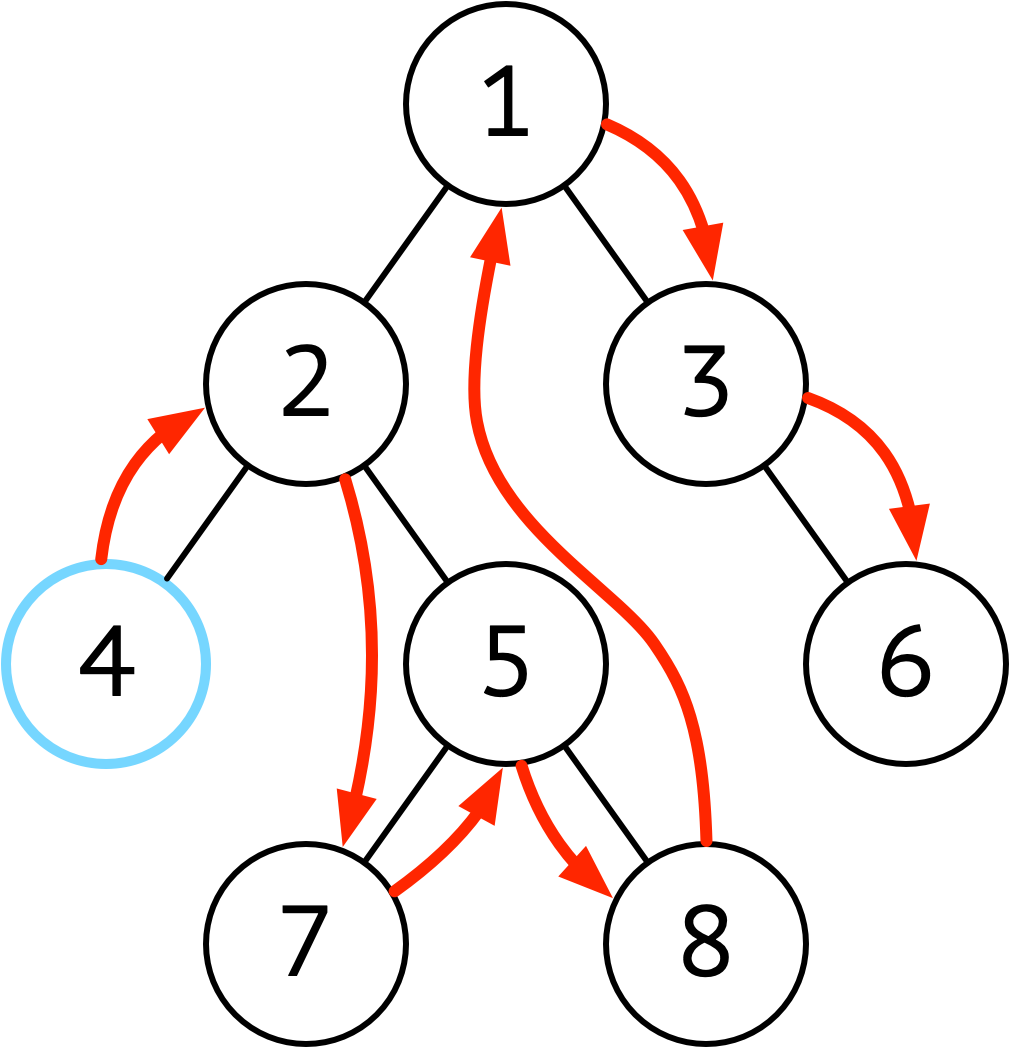 |
42758136 | 在二分搜索树中,中序遍历的顺序符合从小到大(或从大到小)顺序的 要输出排序好的结果使用中序 |
| 后序 | 左 ➜ 右 ➜ 根 | 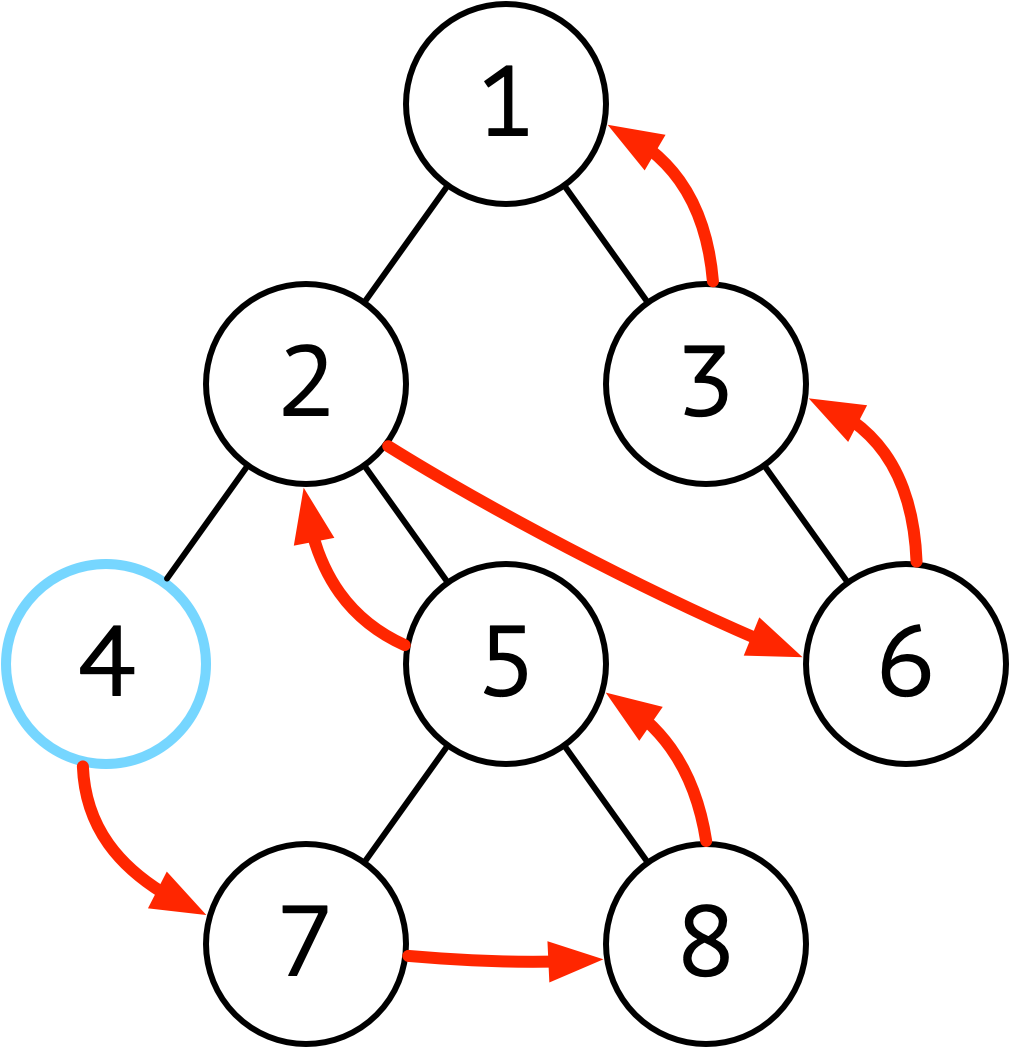 |
47852631 | 后续遍历的特点是在执行操作时,肯定已经遍历过该节点的左右子节点 适用于进行破坏性操作 比如删除所有节点,比如判断树中是否存在相同子树 |
| 广度优先 | 层序,横向访问 | 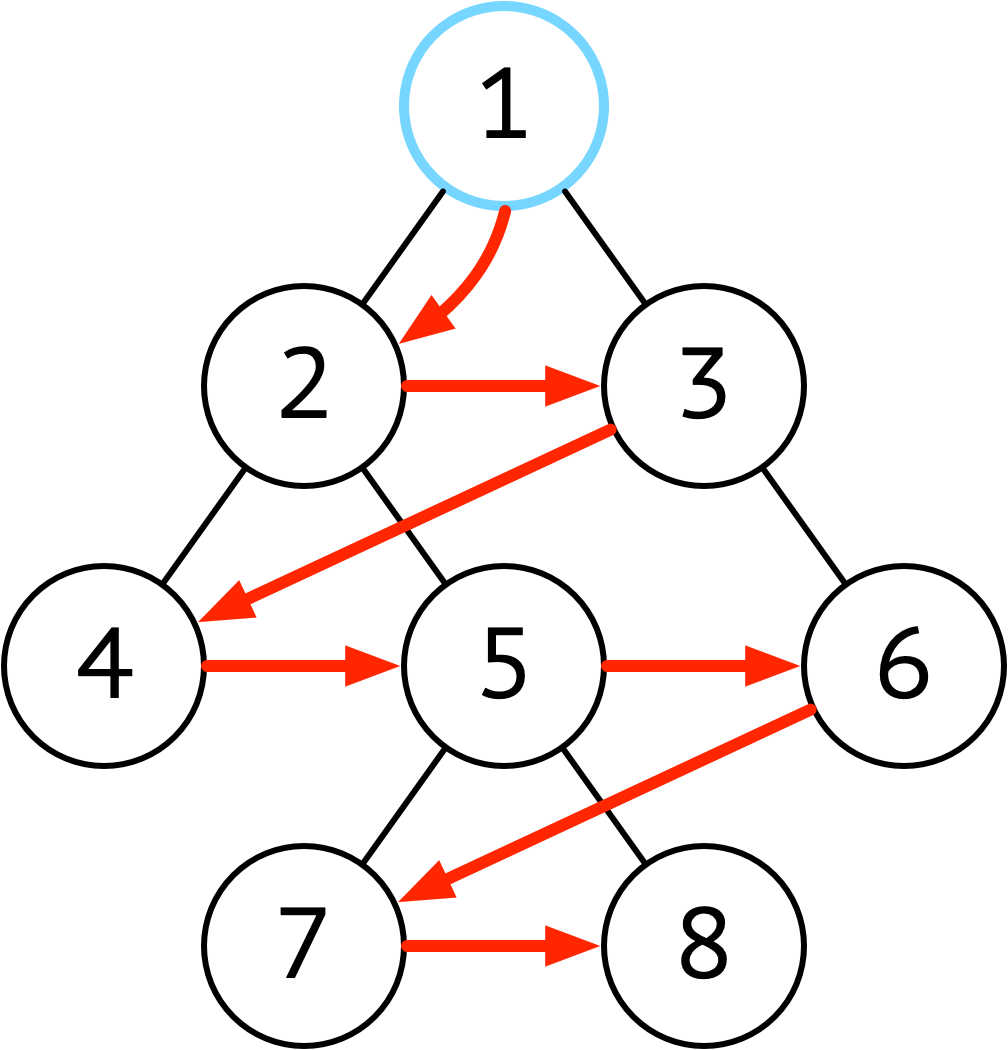 |
当树的高度非常高(非常瘦) 使用广度优先剑节省空间 | |
| 深度优先 | 纵向,探底到叶子节点 | 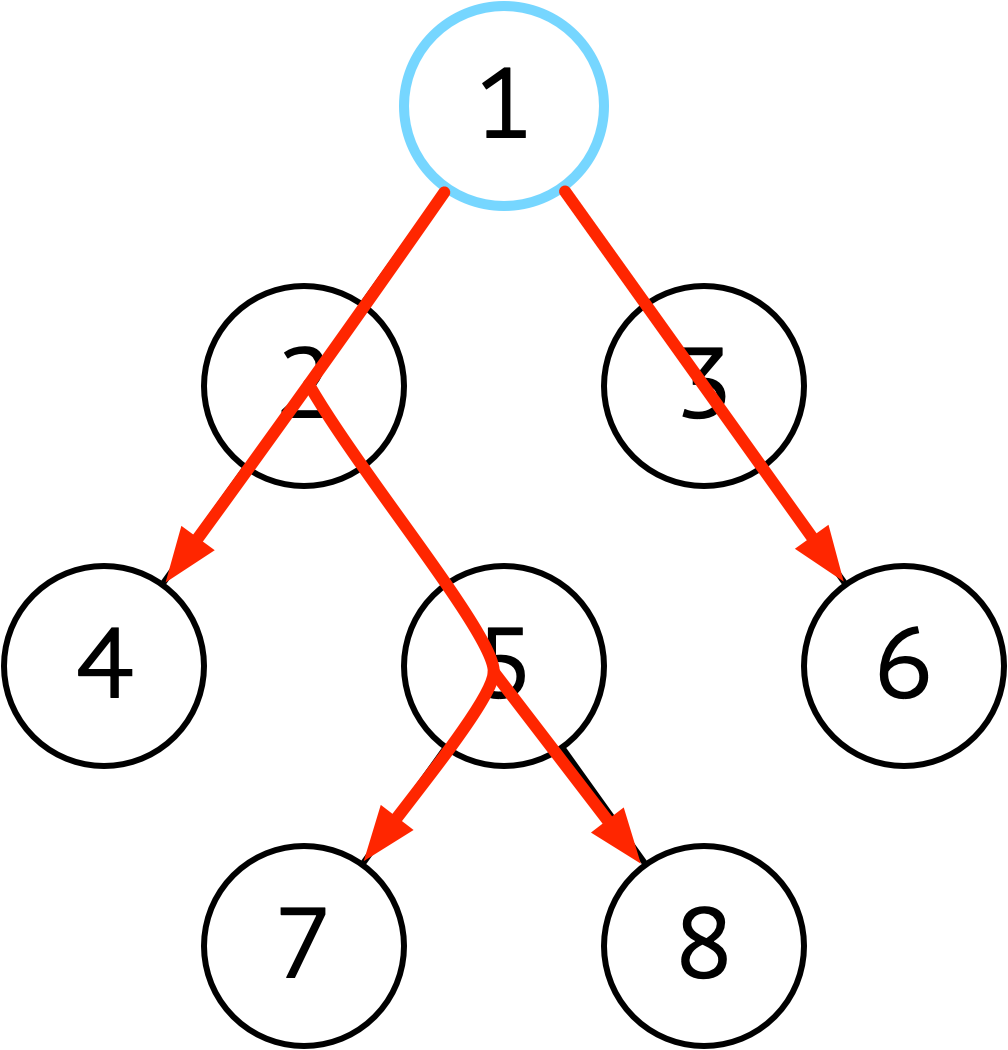 |
12457836 | 当每个节点的子节点非常多(非常胖),使用深度优先遍历节省空间 (访问顺序和入栈顺序相关,想当于先序遍历) |
二叉树是每个节点最多有两个子树的树结构。
- 二叉树中不存在度大于 2 的结点
- 左子树和右子树是有顺序的,次序不能任意颠倒
根据二叉树的定义和特点,可以将二叉树分为五种不同的形态,如下图所示

- 在非空二叉树中,二叉树的第i( i>=1)层最多有2^(i-1)个结点
- 深度为k(k>=1)的二叉树最多有 2^k – 1 个结点,最少有k个结点;
- 对于任意一棵非空二叉树如果其叶结点数为n0,而度为2的非叶结点总数为n2,则n0=n2+1;
- 具有 n (n>=0) 个结点的完全二叉树的深度为 log2(n) +1
- 任意一棵二叉树,其节点个数等于分支个数加1,及n=B+1
- 满二叉树:如果二叉树中除了叶子结点,每个结点的度都为 2,则此二叉树称为满二叉树,也叫严格二叉树
- 二叉树中第 i 层的节点数为 2^(n-1) 个。
- 深度为 k 的满二叉树必有 2^(k-1) 个节点 ,叶子数为 2^(k-1)
- 满二叉树中不存在度为 1 的节点,每一个分支点中都两棵深度相同的子树,且叶子节点都在最底层
- 具有 n 个节点的满二叉树的深度为 log2(n+1)
- 完全二叉树:若设二叉树的深度为h,除第 h 层外,其它各层 (1~(h-1)层) 的结点数都达到最大个数,第h层所有的结点都连续集中在最左边,这就是完全二叉树。

满二叉树一定是一颗棵完全二叉树,但完全二叉树不一定是满二叉树。
二叉树的存储结构有两种,分别为顺序存储和链式存储。
二叉树的顺序存储,指的是使用顺序表(数组)存储二叉树。需要注意的是,顺序存储只适用于完全二叉树。换句话说,只有完全二叉树才可以使用顺序表存储。因此,如果我们想顺序存储普通二叉树,需要提前将普通二叉树转化为完全二叉树。
完全二叉树的顺序存储,仅需从根节点开始,按照层次依次将树中节点存储到数组即可。

普通二叉树转完全二叉树,只需给二叉树额外添加一些节点,将其"拼凑"成完全二叉树即可。

并不是每个二叉树都是完全二叉树,普通二叉树使用顺序表存储或多或少会存在空间浪费的现象,所以就有了链式存储结构。
二叉树的链式存储结构就是用链表来表示一棵二叉树,即用链来指示着元素的逻辑关系。通常有下面两种形式。
链表中每个结点由三个域组成,除了数据域外,还有两个指针域,分别用来给出该结点左孩子和右孩子所在的链结点的存储地址。
其中,data 域存放某结点的数据信息;lchild 与 rchild 分别存放指向左孩子和右孩子的指针,当左孩子或右孩子不存在时,相应指针域值为空(用符号 ∧ 或 NULL 表示)。

为了方便找到父节点,可以在上述结点结构中增加一个指针域,指向结点的父结点。利用此结点结构得到的二叉树存储结构称为三叉链表。

二叉树的遍历方式主要有:先序遍历、中序遍历、后序遍历、层次遍历。
关于应用部分,选择遍历方法的基本的原则:更快的访问到你想访问的节点。先序会先访问根节点,后序会先访问叶子节点
各种遍历算法
《Java数据结构与算法》
二叉查找树定义:又称为是二叉排序树(Binary Sort Tree)或二叉搜索树。二叉排序树要么是一棵空树,要么是具有如下性质的二叉树:
- 若它的左子树不为空,则左子树上所有结点的值均小于它的根结点的值
- 若它的右子树不为空,则右子树上所有结点的值均大于它的根结点的值
- 左、右子树也分别为二叉排序树
- 没有键值相等的节点

二叉查找树是一个递归的数据结构。对二叉查找树进行中序遍历,即可得到有序的数列。
它和二分查找一样,插入和查找的时间复杂度均为O(log2n),但是在最坏的情况下仍然会有O(n)的时间复杂度。原因在于插入和删除元素的时候,树没有保持平衡。我们追求的是在最坏的情况下仍然有较好的时间复杂度,这就是平衡查找树设计的初衷。
二叉查找树的高度决定了二叉查找树的查找效率。
在实行基本操作之前,我们需要先定义一下基本数据类型:
class TreeNode<E extends Comparable<E>>{
    private E data;
    private TreeNode<E> left;
    private TreeNode<E> right;
    TreeNode(E theData){
        data = theData;
        left = null;
        right = null;
    }
}
public class BinarySearchTree<E extends Comparable<E>>{
    private TreeNode<E> root = null;
}假设我们需要遍历树中所有节点,这里有许多递归方法可以实现:
1.中序遍历:当到达某个节点时,先访问左子节点,再输出该节点,最后访问右子节点。
public void inOrder(TreeNode<E> cursor){
    if(cursor == null) return;
    inOrder(cursor.getLeft());
    System.out.println(cursor.getData());
    inOrder(cursor.getRight());
}
2. 前序遍历:当到达某个节点时,先输出该节点,再访问左子节点,最后访问右子节点。
public void preOrder(TreeNode<E> cursor){
    if(cursor == null) return;
    System.out.println(cursor.getData());
    inOrder(cursor.getLeft());
    inOrder(cursor.getRight());
}
3. 后序遍历:当到达某个节点时,先访问左子节点,再访问右子节点,最后输出该节点。
public void postOrder(TreeNode<E> cursor){
    if(cursor == null) return;
    inOrder(cursor.getLeft());
    inOrder(cursor.getRight());
    System.out.println(cursor.getData());
}树的搜索和树的遍历差不多,就是在遍历的时候只搜索不输出就可以了(类比有序数组的搜索)

public boolean searchNode(TreeNode<E> node){
    TreeNode<E> currentNode = root;
    while(true){
        if(currentNode == null){
            return false;
        }
        if(currentNode.getData().compareTo(node.getData()) == 0){
            return true;
        }else if(currentNode.getData().compareTo(node.getData()) < 0){
            currentNode = currentNode.getLeft();
        }else{
            currentNode = currentNode.getRight();
        }
    }
}步骤:
- 递归地去查找该二叉树,找到应该插入的节点
- 若当前的二叉查找树为空,则插入的元素为根节点
- 若插入的元素值小于根节点值,则将元素插入到左子树中
- 若插入的元素值不小于根节点值,则将元素插入到右子树中

public void insertNode(TreeNode<E> node){
    TreeNode<E> currentNode = root;
    if(currentNode == null){
        root = node;
        return;
    }else{
        while(true){
            if(node.getData().compareTo(currentNode.getData()) < 0){
                if(currentNode.getLeft() == null){
                    break;
                }else{
                    currentNode = currentNode.getLeft();
                }
            }else if(node.getData().compareTo(currentNode.getData()) > 0){

                if(currentNode.getRight() == null){
                    break;
                }else{
                    currentNode = currentNode.getRight();
                }
            }
        }
    }
    if(node.getData().compareTo(currentNode.getData()) < 0){
        currentNode.setLeft(node);
    }else if(node.getData().compareTo(currentNode.getData()) > 0){
        currentNode.setRight(node);
    }
}首先需要搜索该节点,然后可以分为以下四种情况进行讨论:
-
如果找不到该节点,那么什么都不用做
-
如果被移除的元素在叶节点(no children):那么直接移除该节点,并且将父节点原本指向该位置改为 null (如果是根节点,那就不用修改父节点指向位置)
-
如果删除的元素只有一个儿子(one child):那么也很简单,直接删除该节点,并且将父节点原本指向的位置改为该儿子 (如果是根节点,那么该儿子成为新的根节点)
例如:要在树中删除元素 20

-
如果删除的元素有两个儿子,那么可以取左子树中最大元素或者右子树中最小元素进行替换,然后将最大元素最小元素原位置置空
例如:要在树中删除元素 15

- 有序数组转为二叉查找树
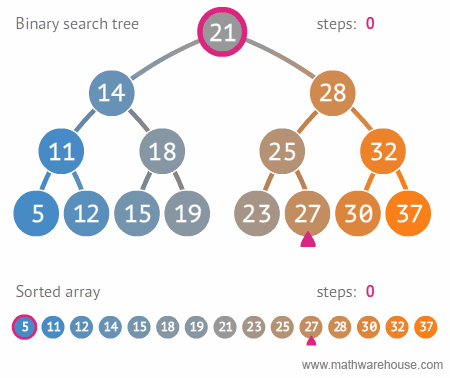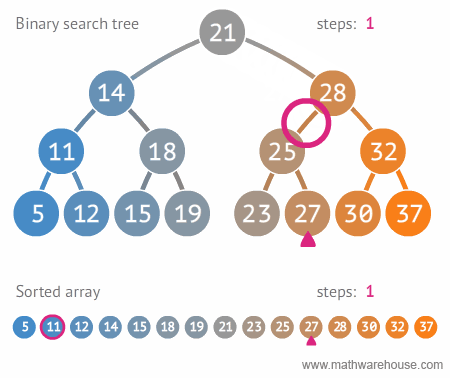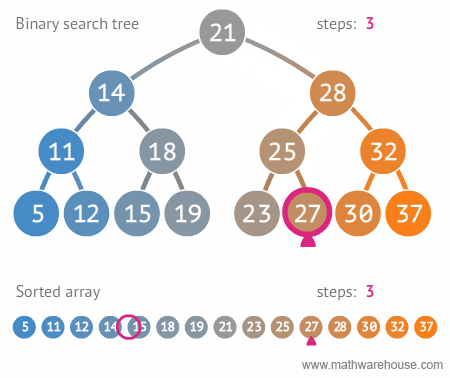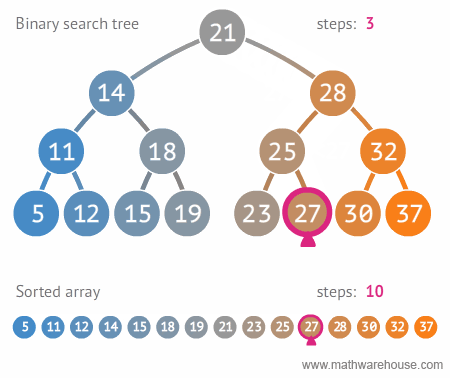
- 将二叉树转为有序数组
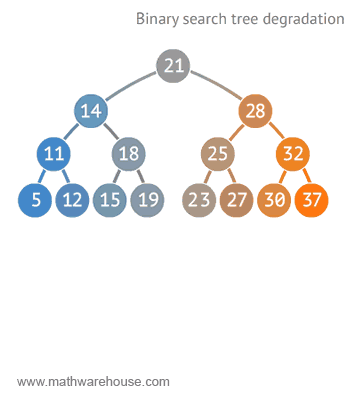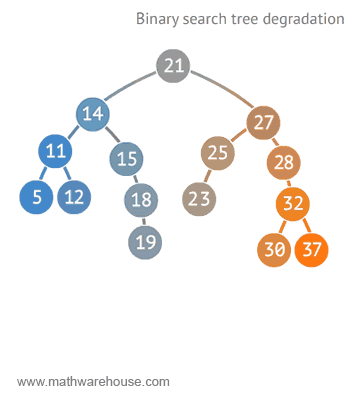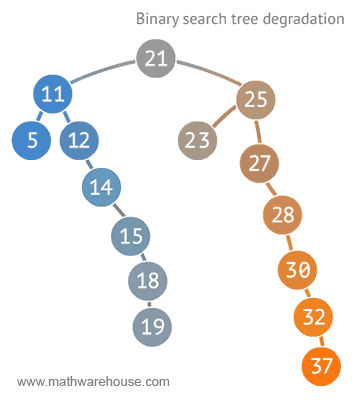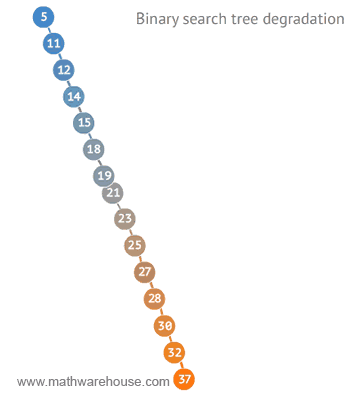
二叉搜索树虽然在插入和删除时的效率都有所提升,但是如果原序列有序时,比如 {3,4,5,6,7},这个时候构造二叉树搜索树就变成了斜树,二叉树退化成单链表,搜索效率降低到 O(n),查找数字 7 的话,需要找 5 次。这又说明了二叉查找树的高度决定了二叉查找树的查找效率。

为了解决这一问题,两位科学家大爷,G. M. Adelson-Velsky和E. M. Landis 又发明了平衡二叉树,又从他两名字中提取出了 AVL,所以平衡二叉树又叫 AVL 树。
二叉搜索树的查找效率取决于树的高度,所以保持树的高度最小,就可保证树的查找效率,如下保持左右平衡,像不像天平?

[todo 这个是吗?]

定义:
平衡二叉查找树,简称平衡二叉树,指的是左子树上的所有节点的值都比根节点的值小,而右子树上的所有节点的值都比根节点的值大,且左子树与右子树的高度差最大为1。因此,平衡二叉树满足所有二叉排序(搜索)树的性质:
- 可以是空树
- 假如不是空树,任何一个结点的左子树与右子树都是平衡二叉树,并且高度之差的绝对值不超过 1
平衡因子:
某节点的左子树与右子树的高度(深度)差即为该节点的平衡因子(BF,Balance Factor),平衡二叉树中不存在平衡因子大于 1 的节点。在一棵平衡二叉树中,节点的平衡因子只能取 0 、1 或者 -1 ,分别对应着左右子树等高,左子树比较高,右子树比较高。
【
在AVL中任何节点的两个儿子子树的高度最大差别为1,所以它也被称为高度平衡树,n个结点的AVL树最大深度约1.44log2n。查找、插入和删除在平均和最坏情况下都是O(logn)。增加和删除可能需要通过一次或多次树旋转来重新平衡这个树。这个方案很好的解决了二叉查找树退化成链表的问题,把插入,查找,删除的时间复杂度最好情况和最坏情况都维持在O(logN)。但是频繁旋转会使插入和删除牺牲掉O(logN)左右的时间,不过相对二叉查找树来说,时间上稳定了很多。
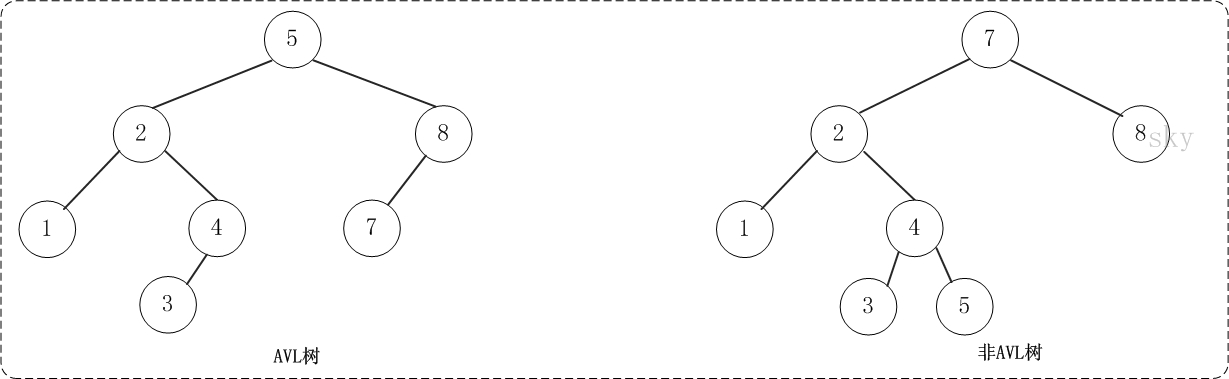
平衡二叉树(AVL树)在符合二叉查找树的条件下,还满足任何节点的两个子树的高度最大差为1。下面的两张图片,左边是AVL树,它的任何节点的两个子树的高度差<=1;右边的不是AVL树,其根节点的左子树高度为3,而右子树高度为1;
如果在AVL树中进行插入或删除节点,可能导致AVL树失去平衡,这种失去平衡的二叉树可以概括为四种姿态:LL(左左)、RR(右右)、LR(左右)、RL(右左)。它们的示意图如下:
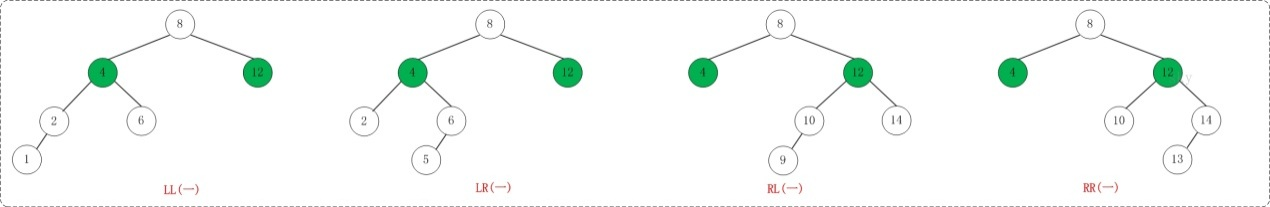
这四种失去平衡的姿态都有各自的定义: LL:LeftLeft,也称“左左”。插入或删除一个节点后,根节点的左孩子(Left Child)的左孩子(Left Child)还有非空节点,导致根节点的左子树高度比右子树高度高2,AVL树失去平衡。
RR:RightRight,也称“右右”。插入或删除一个节点后,根节点的右孩子(Right Child)的右孩子(Right Child)还有非空节点,导致根节点的右子树高度比左子树高度高2,AVL树失去平衡。
LR:LeftRight,也称“左右”。插入或删除一个节点后,根节点的左孩子(Left Child)的右孩子(Right Child)还有非空节点,导致根节点的左子树高度比右子树高度高2,AVL树失去平衡。
RL:RightLeft,也称“右左”。插入或删除一个节点后,根节点的右孩子(Right Child)的左孩子(Left Child)还有非空节点,导致根节点的右子树高度比左子树高度高2,AVL树失去平衡。
AVL树失去平衡之后,可以通过旋转使其恢复平衡。下面分别介绍四种失去平衡的情况下对应的旋转方法。
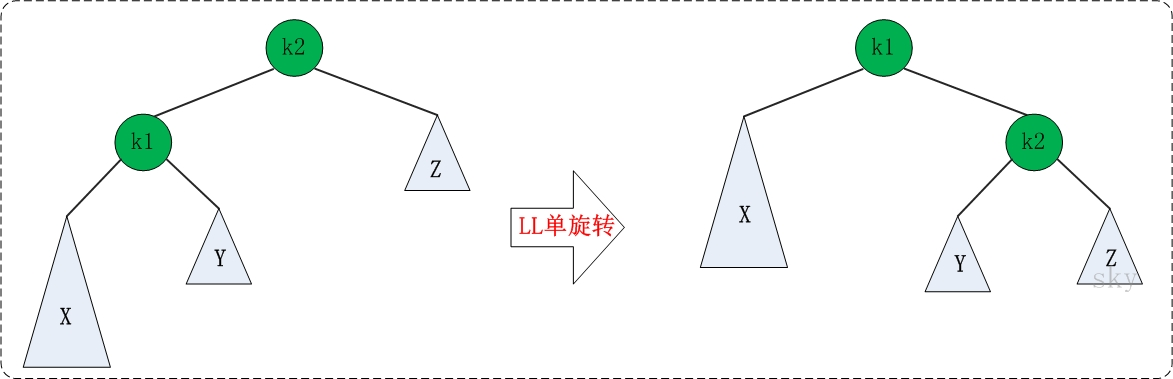
LL的旋转。LL失去平衡的情况下,可以通过一次旋转让AVL树恢复平衡。步骤如下:
- 将根节点的左孩子作为新根节点。
- 将新根节点的右孩子作为原根节点的左孩子。
- 将原根节点作为新根节点的右孩子。
LL旋转示意图如下:
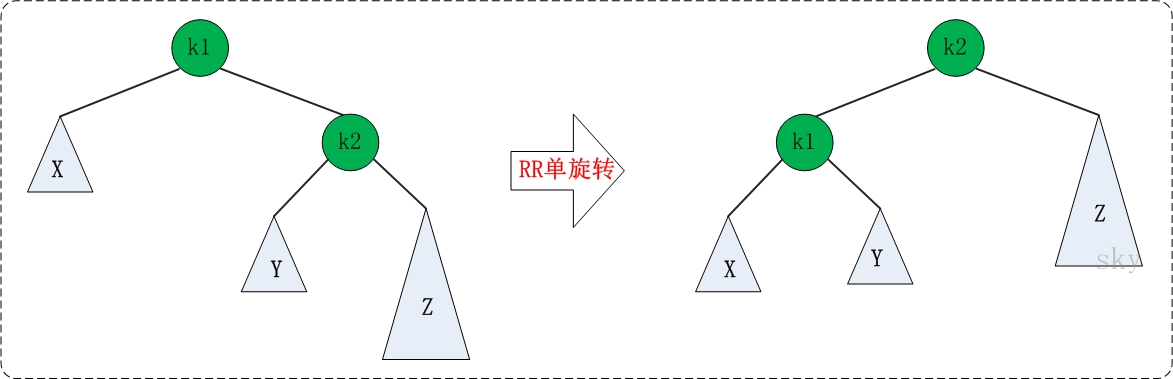
RR的旋转:RR失去平衡的情况下,旋转方法与LL旋转对称,步骤如下:
- 将根节点的右孩子作为新根节点。
- 将新根节点的左孩子作为原根节点的右孩子。
- 将原根节点作为新根节点的左孩子。
RR旋转示意图如下:
LR的旋转:LR失去平衡的情况下,需要进行两次旋转,步骤如下:
- 围绕根节点的左孩子进行RR旋转。
- 围绕根节点进行LL旋转。
LR的旋转示意图如下:
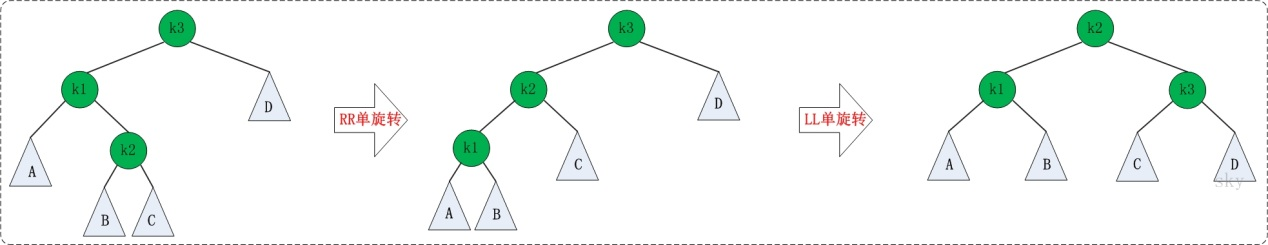
RL的旋转:RL失去平衡的情况下也需要进行两次旋转,旋转方法与LR旋转对称,步骤如下:
- 围绕根节点的右孩子进行LL旋转。
- 围绕根节点进行RR旋转。
RL的旋转示意图如下:
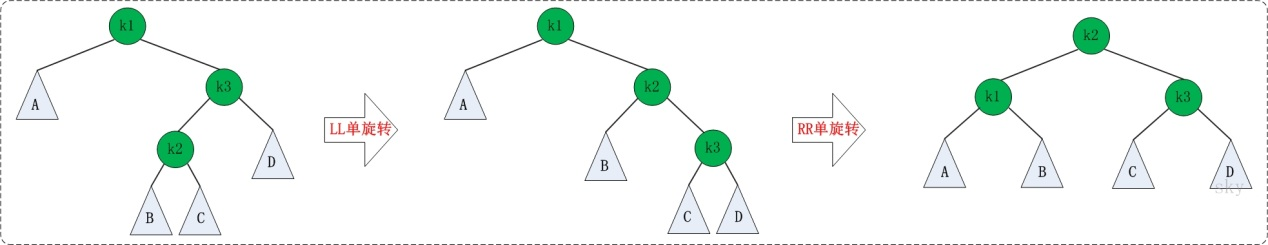
】
平衡二叉树大部分操作和二叉查找树类似,主要不同在于插入删除的时候平衡二叉树的平衡可能被改变,当平衡因子的绝对值大于1的时候,我们就需要对其进行旋转来保持平衡。
假设一颗 AVL 树的某个节点为 A,有四种操作会使 A 的左右子树高度差大于 1,从而破坏了原有 AVL 树的平衡性:
-
在 A 的左儿子的左子树进行一次插入
-
对 A 的左儿子的右子树进行一次插入
-
对 A 的右儿子的左子树进行一次插入
-
对 A 的右儿子的右子树进行一次插入

情形 1 和情形 4 是关于 A 的镜像对称,情形 2 和情形 3 也是关于 A 的镜像对称,因此理论上看只有两种情况,但编程的角度看还是四种情形。
第一种情况是插入发生在“外边”的情形(左左或右右),该情况可以通过一次单旋转完成调整;第二种情况是插入发生在“内部”的情形(左右或右左),这种情况比较复杂,需要通过双旋转来调整。
单旋转又有左旋和右旋之分
情景 1 对 A 的左二子的左子树插入节点,只需要一次右旋即可。
https://www.zhihu.com/search?type=content&q=平衡二叉树
https://www.cxyxiaowu.com/1696.html
https://www.cnblogs.com/zhangbaochong/p/5164994.html
AVL 树和二叉查找树的删除操作情况一致,都分为四种情况:
- 删除叶子节点
- 删除的节点只有左子树
- 删除的节点只有右子树
- 删除的节点既有左子树又有右子树
只不过 AVL 树在删除节点后需要重新检查平衡性并修正,同时,删除操作与插入操作后的平衡修正区别在于,插入操作后只需要对插入栈中的弹出的第一个非平衡节点进行修正,而删除操作需要修正栈中的所有非平衡节点。
删除操作的大致步骤如下:
- 以前三种情况为基础尝试删除节点,并将访问节点入栈。
- 如果尝试删除成功,则依次检查栈顶节点的平衡状态,遇到非平衡节点,即进行旋转平衡,直到栈空。
- 如果尝试删除失败,证明是第四种情况。这时先找到被删除节点的右子树最小节点并删除它,将访问节点继续入栈。
- 再依次检查栈顶节点的平衡状态和修正直到栈空。
对于删除操作造成的非平衡状态的修正,可以这样理解:对左或者右子树的删除操作相当于对右或者左子树的插入操作,然后再对应上插入的四种情况选择相应的旋转就好了。
**红黑树的定义:**红黑树是一种自平衡二叉查找树,是在计算机科学中用到的一种数据结构,典型的用途是实现关联数组。它是在1972年由鲁道夫·贝尔发明的,称之为"对称二叉B树",它现代的名字是在 Leo J. Guibas 和 Robert Sedgewick 于1978年写的一篇论文中获得的。它是复杂的,但它的操作有着良好的最坏情况运行时间,并且在实践中是高效的: 它可以在O(logn)时间内做查找,插入和删除,这里的n是树中元素的数目。
红黑树和AVL树一样都对插入时间、删除时间和查找时间提供了最好可能的最坏情况担保。这不只是使它们在时间敏感的应用如实时应用(real time application)中有价值,而且使它们有在提供最坏情况担保的其他数据结构中作为建造板块的价值;例如,在计算几何中使用的很多数据结构都可以基于红黑树。此外,红黑树还是2-3-4树的一种等同,它们的思想是一样的,只不过红黑树是2-3-4树用二叉树的形式表示的。
红黑树的性质:
红黑树是每个节点都带有颜色属性的二叉查找树,颜色为红色或黑色。在二叉查找树强制的一般要求以外,对于任何有效的红黑树我们增加了如下的额外要求:
- 每个节点要么是黑色,要么是红色
- 根节点是黑色
- 所有叶子都是黑色(叶子是NIL节点)
- 每个红色节点必须有两个黑色的子节点(从每个叶子到根的所有路径上不能有两个连续的红色节点)
- 任意一结点到每个叶子结点的简单路径都包含数量相同的黑结点
下面是一个具体的红黑树的图例:

这些约束确保了红黑树的关键特性: 从根到叶子的最长的可能路径不多于最短的可能路径的两倍长。结果是这个树大致上是平衡的。因为操作比如插入、删除和查找某个值的最坏情况时间都要求与树的高度成比例,这个在高度上的理论上限允许红黑树在最坏情况下都是高效的,而不同于普通的二叉查找树。
要知道为什么这些性质确保了这个结果,注意到性质4导致了路径不能有两个毗连的红色节点就足够了。最短的可能路径都是黑色节点,最长的可能路径有交替的红色和黑色节点。因为根据性质5所有最长的路径都有相同数目的黑色节点,这就表明了没有路径能多于任何其他路径的两倍长。
红黑树的自平衡操作:
因为每一个红黑树也是一个特化的二叉查找树,因此红黑树上的只读操作与普通二叉查找树上的只读操作相同。然而,在红黑树上进行插入操作和删除操作会导致不再符合红黑树的性质。恢复红黑树的性质需要少量(O(logn))的颜色变更(实际是非常快速的)和不超过三次树旋转(对于插入操作是两次)。虽然插入和删除很复杂,但操作时间仍可以保持为O(logn) 次。
**我们首先以二叉查找树的方法增加节点并标记它为红色。如果设为黑色,就会导致根到叶子的路径上有一条路上,多一个额外的黑节点,这个是很难调整的(违背性质5)。**但是设为红色节点后,可能会导致出现两个连续红色节点的冲突,那么可以通过颜色调换(color flips)和树旋转来调整。下面要进行什么操作取决于其他临近节点的颜色。同人类的家族树中一样,我们将使用术语叔父节点来指一个节点的父节点的兄弟节点。注意:
- 性质1和性质3总是保持着。
- 性质4只在增加红色节点、重绘黑色节点为红色,或做旋转时受到威胁。
- 性质5只在增加黑色节点、重绘红色节点为黑色,或做旋转时受到威胁。
插入操作:
假设,将要插入的节点标为N,N的父节点标为P,N的祖父节点标为G,N的叔父节点标为U。在图中展示的任何颜色要么是由它所处情形这些所作的假定,要么是假定所暗含的。
情形1: 该树为空树,直接插入根结点的位置,违反性质1,把节点颜色由红改为黑即可。
情形2: 插入节点N的父节点P为黑色,不违反任何性质,无需做任何修改。在这种情形下,树仍是有效的。性质5也未受到威胁,尽管新节点N有两个黑色叶子子节点;但由于新节点N是红色,通过它的每个子节点的路径就都有同通过它所取代的黑色的叶子的路径同样数目的黑色节点,所以依然满足这个性质。
注: 情形1很简单,情形2中P为黑色,一切安然无事,但P为红就不一样了,下边是P为红的各种情况,也是真正难懂的地方。
情形3: 如果父节点P和叔父节点U二者都是红色,(此时新插入节点N做为P的左子节点或右子节点都属于情形3,这里右图仅显示N做为P左子的情形)则我们可以将它们两个重绘为黑色并重绘祖父节点G为红色(用来保持性质4)。现在我们的新节点N有了一个黑色的父节点P。因为通过父节点P或叔父节点U的任何路径都必定通过祖父节点G,在这些路径上的黑节点数目没有改变。但是,红色的祖父节点G的父节点也有可能是红色的,这就违反了性质4。为了解决这个问题,我们在祖父节点G上递归地进行上述情形的整个过程(把G当成是新加入的节点进行各种情形的检查)。比如,G为根节点,那我们就直接将G变为黑色(情形1);如果G不是根节点,而它的父节点为黑色,那符合所有的性质,直接插入即可(情形2);如果G不是根节点,而它的父节点为红色,则递归上述过程(情形3)。

情形4: 父节点P是红色而叔父节点U是黑色或缺少,新节点N是其父节点的左子节点,而父节点P又是其父节点G的左子节点。在这种情形下,我们进行针对祖父节点G的一次右旋转; 在旋转产生的树中,以前的父节点P现在是新节点N和以前的祖父节点G的父节点。我们知道以前的祖父节点G是黑色,否则父节点P就不可能是红色(如果P和G都是红色就违反了性质4,所以G必须是黑色)。我们切换以前的父节点P和祖父节点G的颜色,结果的树满足性质4。性质5也仍然保持满足,因为通过这三个节点中任何一个的所有路径以前都通过祖父节点G,现在它们都通过以前的父节点P。在各自的情形下,这都是三个节点中唯一的黑色节点。
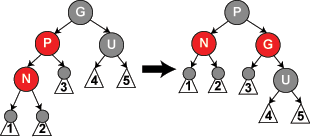
情形5: 父节点P是红色而叔父节点U是黑色或缺少,并且新节点N是其父节点P的右子节点而父节点P又是其父节点的左子节点。在这种情形下,我们进行一次左旋转调换新节点和其父节点的角色; 接着,我们按情形4处理以前的父节点P以解决仍然失效的性质4。注意这个改变会导致某些路径通过它们以前不通过的新节点N(比如图中1号叶子节点)或不通过节点P(比如图中3号叶子节点),但由于这两个节点都是红色的,所以性质5仍有效。

注: 插入实际上是原地算法,因为上述所有调用都使用了尾部递归。
删除操作:
如果需要删除的节点有两个儿子,那么问题可以被转化成删除另一个只有一个儿子的节点的问题。对于二叉查找树,在删除带有两个非叶子儿子的节点的时候,我们找到要么在它的左子树中的最大元素、要么在它的右子树中的最小元素,并把它的值转移到要删除的节点中。我们接着删除我们从中复制出值的那个节点,它必定有少于两个非叶子的儿子。因为只是复制了一个值,不违反任何性质,这就把问题简化为如何删除最多有一个儿子的节点的问题。它不关心这个节点是最初要删除的节点还是我们从中复制出值的那个节点。
我们只需要讨论删除只有一个儿子的节点(如果它两个儿子都为空,即均为叶子,我们任意将其中一个看作它的儿子)。如果我们删除一个红色节点(此时该节点的儿子将都为叶子节点),它的父亲和儿子一定是黑色的。所以我们可以简单的用它的黑色儿子替换它,并不会破坏性质3和性质4。通过被删除节点的所有路径只是少了一个红色节点,这样可以继续保证性质5。另一种简单情况是在被删除节点是黑色而它的儿子是红色的时候。如果只是去除这个黑色节点,用它的红色儿子顶替上来的话,会破坏性质5,但是如果我们重绘它的儿子为黑色,则曾经通过它的所有路径将通过它的黑色儿子,这样可以继续保持性质5。
需要进一步讨论的是在要删除的节点和它的儿子二者都是黑色的时候,这是一种复杂的情况。我们首先把要删除的节点替换为它的儿子。出于方便,称呼这个儿子为N(在新的位置上),称呼它的兄弟(它父亲的另一个儿子)为S。在下面的示意图中,我们还是使用P称呼N的父亲,SL称呼S的左儿子,SR称呼S的右儿子。
如果N和它初始的父亲是黑色,则删除它的父亲导致通过N的路径都比不通过它的路径少了一个黑色节点。因为这违反了性质5,树需要被重新平衡。有几种情形需要考虑:
情形1: N是新的根。在这种情形下,我们就做完了。我们从所有路径去除了一个黑色节点,而新根是黑色的,所以性质都保持着。
注意: 在情形2、5和6下,我们假定N是它父亲的左儿子。如果它是右儿子,则在这些情形下的左和右应当对调。
情形2: S是红色。在这种情形下我们在N的父亲上做左旋转,把红色兄弟转换成N的祖父,我们接着对调N的父亲和祖父的颜色。完成这两个操作后,尽管所有路径上黑色节点的数目没有改变,但现在N有了一个黑色的兄弟和一个红色的父亲(它的新兄弟是黑色因为它是红色S的一个儿子),所以我们可以接下去按情形4、情形5或情形6来处理。

情形3: N的父亲、S和S的儿子都是黑色的。在这种情形下,我们简单的重绘S为红色。结果是通过S的所有路径,它们就是以前不通过N的那些路径,都少了一个黑色节点。因为删除N的初始的父亲使通过N的所有路径少了一个黑色节点,这使事情都平衡了起来。但是,通过P的所有路径现在比不通过P的路径少了一个黑色节点,所以仍然违反性质5。要修正这个问题,我们要从情形1开始,在P上做重新平衡处理。
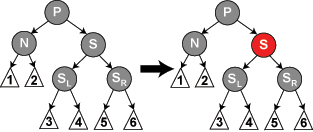
情形4: S和S的儿子都是黑色,但是N的父亲是红色。在这种情形下,我们简单的交换N的兄弟和父亲的颜色。这不影响不通过N的路径的黑色节点的数目,但是它在通过N的路径上对黑色节点数目增加了一,添补了在这些路径上删除的黑色节点。

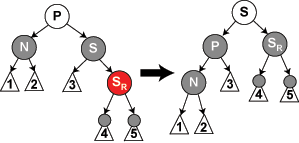
情形5: S是黑色,S的左儿子是红色,S的右儿子是黑色,而N是它父亲的左儿子。在这种情形下我们在S上做右旋转,这样S的左儿子成为S的父亲和N的新兄弟。我们接着交换S和它的新父亲的颜色。所有路径仍有同样数目的黑色节点,但是现在N有了一个黑色兄弟,他的右儿子是红色的,所以我们进入了情形6。N和它的父亲都不受这个变换的影响。
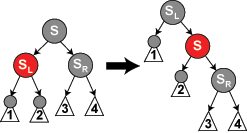
情形6: S是黑色,S的右儿子是红色,而N是它父亲的左儿子。在这种情形下我们在N的父亲上做左旋转,这样S成为N的父亲(P)和S的右儿子的父亲。我们接着交换N的父亲和S的颜色,并使S的右儿子为黑色。子树在它的根上的仍是同样的颜色,所以性质3没有被违反。但是,N现在增加了一个黑色祖先: 要么N的父亲变成黑色,要么它是黑色而S被增加为一个黑色祖父。所以,通过N的路径都增加了一个黑色节点。
此时,如果一个路径不通过N,则有两种可能性:
- 它通过N的新兄弟。那么它以前和现在都必定通过S和N的父亲,而它们只是交换了颜色。所以路径保持了同样数目的黑色节点。
- 它通过N的新叔父,S的右儿子。那么它以前通过S、S的父亲和S的右儿子,但是现在只通过S,它被假定为它以前的父亲的颜色,和S的右儿子,它被从红色改变为黑色。合成效果是这个路径通过了同样数目的黑色节点。
在任何情况下,在这些路径上的黑色节点数目都没有改变。所以我们恢复了性质4。在示意图中的白色节点可以是红色或黑色,但是在变换前后都必须指定相同的颜色。
B树也是一种用于查找的平衡树,但是它不是二叉树。
B-tree 树即 B 树**,B即Balanced,平衡的意思。因为B树的原英文名称为B-tree,而国内很多人喜欢把B-tree译作B-树,其实,这是个非常不好的直译,很容易让人产生误解。如可能会以为B-树是一种树,而B树又是另一种树。而事实上是,B-tree就是指的B树**。特此说明。
**B树的定义:**B树(B-tree)是一种树状数据结构,能够用来存储排序后的数据。这种数据结构能够让查找数据、循序存取、插入数据及删除的动作,都在对数时间内完成。
B树,概括来说是一个一般化的二叉查找树,可以拥有多于2个子节点。与自平衡二叉查找树不同,B-树为系统最优化大块数据的读和写操作。B-tree算法减少定位记录时所经历的中间过程,从而加快存取速度。这种数据结构常被应用在数据库和文件系统的实作上。
在B树中查找给定关键字的方法是,首先把根结点取来,在根结点所包含的关键字K1,…,Kn查找给定的关键字(可用顺序查找或二分查找法),若找到等于给定值的关键字,则查找成功;否则,一定可以确定要查找的关键字在Ki与Ki+1之间,Pi为指向子树根节点的指针,此时取指针Pi所指的结点继续查找,直至找到,或指针Pi为空时查找失败。
B树作为一种多路搜索树(并不是二叉的):
B树的性质
M为树的阶数,B-树或为空树,否则满足下列条件:
- 定义任意非叶子结点最多只有M个儿子;且M>2;
- 根结点的儿子数为[2, M];
- 除根结点以外的非叶子结点的儿子数为[M/2, M];
- 每个结点存放至少M/2-1(取上整)和至多M-1个关键字;(至少2个关键字)
- 非叶子结点的关键字个数=指向儿子的指针个数-1;
- 非叶子结点的关键字:K[1], K[2], …, K[M-1];且K[i] < K[i+1];
- 非叶子结点的指针:P[1], P[2], …, P[M];其中P[1]指向关键字小于K[1]的子树,P[M]指向关键字大于K[M-1]的子树,其它P[i]指向关键字属于(K[i-1], K[i])的子树;
- 所有叶子结点位于同一层;
如下图为一个M=3的B树示例:
B树创建的示意图:

B-树的搜索,从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点。
B-Tree是为磁盘等外存储设备设计的一种平衡查找树。因此在讲B-Tree之前先了解下磁盘的相关知识。
系统从磁盘读取数据到内存时是以磁盘块(block)为基本单位的,位于同一个磁盘块中的数据会被一次性读取出来,而不是需要什么取什么。
InnoDB存储引擎中有页(Page)的概念,页是其磁盘管理的最小单位。InnoDB存储引擎中默认每个页的大小为16KB,可通过参数innodb_page_size将页的大小设置为4K、8K、16K,在MySQL中可通过如下命令查看页的大小:
mysql> show variables like 'innodb_page_size';
-
1
-
1
而系统一个磁盘块的存储空间往往没有这么大,因此InnoDB每次申请磁盘空间时都会是若干地址连续磁盘块来达到页的大小16KB。InnoDB在把磁盘数据读入到磁盘时会以页为基本单位,在查询数据时如果一个页中的每条数据都能有助于定位数据记录的位置,这将会减少磁盘I/O次数,提高查询效率。
B-Tree结构的数据可以让系统高效的找到数据所在的磁盘块。为了描述B-Tree,首先定义一条记录为一个二元组[key, data] ,key为记录的键值,对应表中的主键值,data为一行记录中除主键外的数据。对于不同的记录,key值互不相同。
一棵m阶的B-Tree有如下特性:
- 每个节点最多有m个孩子。
- 除了根节点和叶子节点外,其它每个节点至少有Ceil(m/2)个孩子(其中ceil(x)是一个取上限的函数)。
- 若根节点不是叶子节点,则至少有2个孩子
- 所有叶子节点都在同一层,且不包含其它关键字信息
- 每个非终端节点包含n个关键字信息(P0,P1,…Pn, k1,…kn)
- 关键字的个数n满足:ceil(m/2)-1 <= n <= m-1
- ki(i=1,…n)为关键字,且关键字升序排序。
- Pi(i=1,…n)为指向子树根节点的指针。P(i-1)指向的子树的所有节点关键字均小于ki,但都大于k(i-1)
B-Tree中的每个节点根据实际情况可以包含大量的关键字信息和分支,如下图所示为一个3阶的B-Tree:
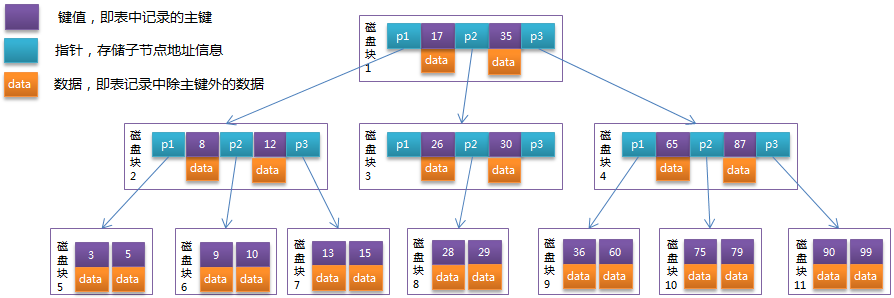
每个节点占用一个盘块的磁盘空间,一个节点上有两个升序排序的关键字和三个指向子树根节点的指针,指针存储的是子节点所在磁盘块的地址。两个关键词划分成的三个范围域对应三个指针指向的子树的数据的范围域。以根节点为例,关键字为17和35,P1指针指向的子树的数据范围为小于17,P2指针指向的子树的数据范围为17~35,P3指针指向的子树的数据范围为大于35。
模拟查找关键字29的过程:
- 根据根节点找到磁盘块1,读入内存。【磁盘I/O操作第1次】
- 比较关键字29在区间(17,35),找到磁盘块1的指针P2。
- 根据P2指针找到磁盘块3,读入内存。【磁盘I/O操作第2次】
- 比较关键字29在区间(26,30),找到磁盘块3的指针P2。
- 根据P2指针找到磁盘块8,读入内存。【磁盘I/O操作第3次】
- 在磁盘块8中的关键字列表中找到关键字29。
分析上面过程,发现需要3次磁盘I/O操作,和3次内存查找操作。由于内存中的关键字是一个有序表结构,可以利用二分法查找提高效率。而3次磁盘I/O操作是影响整个B-Tree查找效率的决定因素。B-Tree相对于AVLTree缩减了节点个数,使每次磁盘I/O取到内存的数据都发挥了作用,从而提高了查询效率。
B+树是B树的变体,也是一种多路搜索树:
1) 其定义基本与B-树相同,除了:
2) 非叶子结点的子树指针与关键字个数相同;
3) 非叶子结点的子树指针P[i],指向关键字值属于[K[i], K[i+1])的子树(B-树是开区间);
4) 为所有叶子结点增加一个链指针;
5) 所有关键字都在叶子结点出现;
下图为M=3的B+树的示意图:

B+树的搜索与B树也基本相同,区别是B+树只有达到叶子结点才命中(B树可以在非叶子结点命中),其性能也等价于在关键字全集做一次二分查找;
B+的性质:
1.所有关键字都出现在叶子结点的链表中(稠密索引),且链表中的关键字恰好是有序的;
2.不可能在非叶子结点命中;
3.非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层;
4.更适合文件索引系统。
下面为一个B+树创建的示意图:

B+Tree是在B-Tree基础上的一种优化,使其更适合实现外存储索引结构,InnoDB存储引擎就是用B+Tree实现其索引结构。
从上一节中的B-Tree结构图中可以看到每个节点中不仅包含数据的key值,还有data值。而每一个页的存储空间是有限的,如果data数据较大时将会导致每个节点(即一个页)能存储的key的数量很小,当存储的数据量很大时同样会导致B-Tree的深度较大,增大查询时的磁盘I/O次数,进而影响查询效率。在B+Tree中,所有数据记录节点都是按照键值大小顺序存放在同一层的叶子节点上,而非叶子节点上只存储key值信息,这样可以大大加大每个节点存储的key值数量,降低B+Tree的高度。
B+Tree相对于B-Tree有几点不同:
- 非叶子节点只存储键值信息。
- 所有叶子节点之间都有一个链指针。
- 数据记录都存放在叶子节点中。
将上一节中的B-Tree优化,由于B+Tree的非叶子节点只存储键值信息,假设每个磁盘块能存储4个键值及指针信息,则变成B+Tree后其结构如下图所示:
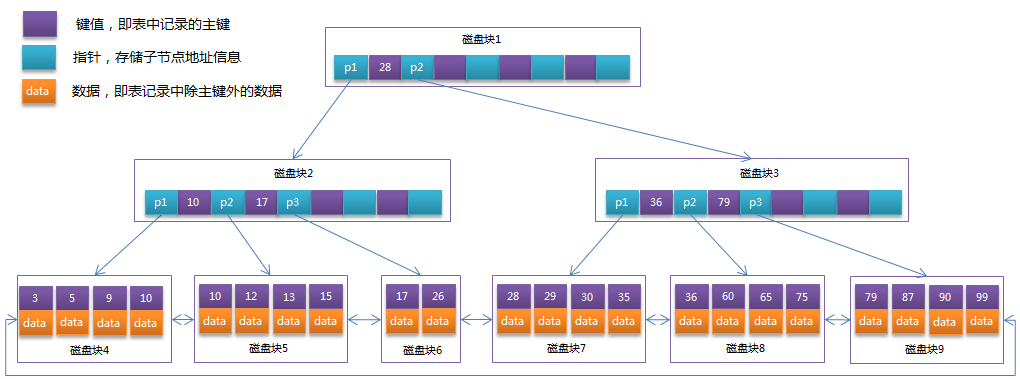
通常在B+Tree上有两个头指针,一个指向根节点,另一个指向关键字最小的叶子节点,而且所有叶子节点(即数据节点)之间是一种链式环结构。因此可以对B+Tree进行两种查找运算:一种是对于主键的范围查找和分页查找,另一种是从根节点开始,进行随机查找。
可能上面例子中只有22条数据记录,看不出B+Tree的优点,下面做一个推算:
InnoDB存储引擎中页的大小为16KB,一般表的主键类型为INT(占用4个字节)或BIGINT(占用8个字节),指针类型也一般为4或8个字节,也就是说一个页(B+Tree中的一个节点)中大概存储16KB/(8B+8B)=1K个键值(因为是估值,为方便计算,这里的K取值为〖10〗^3)。也就是说一个深度为3的B+Tree索引可以维护10^3 * 10^3 * 10^3 = 10亿 条记录。
实际情况中每个节点可能不能填充满,因此在数据库中,B+Tree的高度一般都在24层。mysql的InnoDB存储引擎在设计时是将根节点常驻内存的,也就是说查找某一键值的行记录时最多只需要13次磁盘I/O操作。
数据库中的B+Tree索引可以分为聚集索引(clustered index)和辅助索引(secondary index)。上面的B+Tree示例图在数据库中的实现即为聚集索引,聚集索引的B+Tree中的叶子节点存放的是整张表的行记录数据。辅助索引与聚集索引的区别在于辅助索引的叶子节点并不包含行记录的全部数据,而是存储相应行数据的聚集索引键,即主键。当通过辅助索引来查询数据时,InnoDB存储引擎会遍历辅助索引找到主键,然后再通过主键在聚集索引中找到完整的行记录数据。
B*树是B+树的变体,在B+树的非根和非叶子结点再增加指向兄弟的指针,将结点的最低利用率从1/2提高到2/3。
B*树如下图所示:

B*树定义了非叶子结点关键字个数至少为(2/3)*M,即块的最低使用率为2/3(代替B+树的1/2);
B+树的分裂:当一个结点满时,分配一个新的结点,并将原结点中1/2的数据复制到新结点,最后在父结点中增加新结点的指针;B+树的分裂只影响原结点和父结点,而不会影响兄弟结点,所以它不需要指向兄弟的指针;
B*树的分裂:当一个结点满时,如果它的下一个兄弟结点未满,那么将一部分数据移到兄弟结点中,再在原结点插入关键字,最后修改父结点中兄弟结点的关键字(因为兄弟结点的关键字范围改变了);如果兄弟也满了,则在原结点与兄弟结点之间增加新结点,并各复制1/3的数据到新结点,最后在父结点增加新结点的指针;
所以,B*树分配新结点的概率比B+树要低,空间使用率更高。
Tire树称为字典树,又称单词查找树,Trie树,是一种树形结构,是一种哈希树的变种。典型应用是用于统计,排序和保存大量的字符串(但不仅限于字符串),所以经常被搜索引擎系统用于文本词频统计。它的优点是:利用字符串的公共前缀来减少查询时间,最大限度地减少无谓的字符串比较,查询效率比哈希树高。
Tire树的三个基本性质:
1) 根节点不包含字符,除根节点外每一个节点都只包含一个字符;
2) 从根节点到某一节点,路径上经过的字符连接起来,为该节点对应的字符串;
3) 每个节点的所有子节点包含的字符都不相同。
Tire树的应用:
1) 串的快速检索
给出N个单词组成的熟词表,以及一篇全用小写英文书写的文章,请你按最早出现的顺序写出所有不在熟词表中的生词。
在这道题中,我们可以用数组枚举,用哈希,用字典树,先把熟词建一棵树,然后读入文章进行比较,这种方法效率是比较高的。
2) “串”排序
给定N个互不相同的仅由一个单词构成的英文名,让你将他们按字典序从小到大输出。用字典树进行排序,采用数组的方式创建字典树,这棵树的每个结点的所有儿子很显然地按照其字母大小排序。对这棵树进行先序遍历即可。
3) 最长公共前缀
对所有串建立字典树,对于两个串的最长公共前缀的长度即他们所在的结点的公共祖先个数,于是,问题就转化为求公共祖先的问题。
https://www.cnblogs.com/maybe2030/p/4732377.html
https://www.jianshu.com/p/45661b029292
https://charlesliuyx.github.io/2018/10/22/[直观算法]树的基本操作/
https://www.jianshu.com/p/45661b029292
https://www.cnblogs.com/gaochundong/p/binary_search_tree.html