
Redis 是怎么想的:用跳表来实现有序集合?
干过服务端开发的应该都知道 Redis 的 ZSet 使用跳表实现的(当然还有压缩列表),我就不从 1990 年的那个美国大佬 William Pugh 发表的那篇论文开始了,直接开跳
文章拢共两部分
- 跳表是怎么搞的
- Redis 是怎么想的
跳表,英文名:Skip List。
父亲:从英文名可以看出来,它首先是个 List,实际上,它是在有序链表的基础上发展起来的。
竞争对手:跳表(skip list) 对标的是平衡树(AVL Tree),
优点:是一种 插入/删除/搜索 都是 O(log n) 的数据结构。它最大的优势是原理简单、容易实现、方便扩展、效率更高。
一如往常,采用循序渐进的手法带你窥探 William Pugh 的小心思~
前提:跳表处理的是有序的链表,所以我们先看个不能再普通了的有序列表(一般是双向链表)

如果我们想查找某个数,只能遍历链表逐个比对,时间复杂度
为了提高查找效率,我们对链表做个”索引“

像这样,我们每隔一个节点取一个数据作为索引节点,比如我们要找 31 直接在索引链表就找到了(遍历 3 次),如果找 16 的话,在遍历到 31的时候,发现大于目标节点,就跳到下一层,接着遍历~ (蓝线表示搜索路径)
恩,如果你数了下遍历次数,没错,加不加索引都是 4 次遍历才能找到 16,这是因为数据量太少,数据量多的话,我们也可以多建几层索引

每家一层索引,我们搜索的时间复杂度就降为原来的
加了几层索引,查找一个节点需要遍历的节点个数明线减少了,效率提高不少,bingo~
那到底提高了多少呢?要加多少层索引呢?
我们知道上层的节点数目为

在上面的 4 层链表中搜索 25,在最上层搜索时就可以直接跳过 21 之前的所有节点,因此十分高效。
更一般地,如果有 kk 层,我们需要的搜索次数会小于
上节的结构是“静态”的,即我们先拥有了一个链表,再在之上建了多层的索引。但是在实际使用中,我们的链表是通过多次插入/删除形成的,换句话说是“动态”的。上节的结构要求上层相邻节点与对应下层节点间的个数比是 1:2,随意插入/删除一个节点,这个要求就被被破坏了。
因此跳表(skip list)表示,我们就不强制要求 1:2 了,一个节点要不要被索引,建几层的索引,都在节点插入时由抛硬币决定。当然,虽然索引的节点、索引的层数是随机的,为了保证搜索的效率,要大致保证每层的节点数目与上节的结构相当。下面是一个随机生成的跳表:

可以看到它每层的节点数还和上节的结构差不多,但是上下层的节点的对应关系已经完全被打破了。
现在假设节点 17 是最后插入的,在插入之前,我们需要搜索得到插入的位置:

接着,抛硬币决定要建立几层的索引,伪代码如下:
randomLevel()
    lvl := 1
    -- random() that returns a random value in [0...1)
    while random() < p and lvl < MaxLevel do
        lvl := lvl + 1
    return lvl
上面的伪代码相当于抛硬币,如果是正面(random() < p)则层数加一,直到抛出反面为止。其中的 MaxLevel 是防止如果运气太好,层数就会太高,而太高的层数往往并不会提供额外的性能,一般 randomLevel 返回的结果是 2,那么就得到下面的结果。
如果要删除节点,则把节点和对应的所有索引节点全部删除即可。当然,要删除节点时需要先搜索得到该节点,搜索过程中可以把路径记录下来,这样删除索引层节点的时候就不需要多次搜索了。
显然,在最坏的情况下,所有节点都没有创建索引,时间复杂度为$O(n)$,但在平均情况下,搜索的时间复杂度却是
一些严格的证明会涉及到比较复杂的概率统计学知识,所以这里只是简单地说明。
上面我们提到 MaxLevel,原版论文 中用 L(n) 来表示,要求 L(n) 层有 1/p 个节点,在搜索时可以不理会比 L(n) 更高的层数,直接从 L(n) 层开始搜索,这样效率最高。
直观上看,第 l 层的节点中在第
于是代入
上面推导到每层的节点数目,直观上看,如果某一层的节点数目小于等于 1,则可以认为它是最高层了,代入
实际上这个问题并没有直接的解析解,我们能知道的是,当
为了计算搜索的时间复杂度,我们可以将查找的过程倒过来,从搜索最后的节点开始,一直向左或向上,直到最顶层。如下图,在路径上的每一点,都可能有两种情况:

- 节点有上一层的节点,向上。这种情况出现的概率是
p。 - 节点没有上一层的节点,向左。出现的概率是
1-p。
于是,设 C(k) 为反向搜索爬到第 k 层的平均路径长度,则有:
C(0) = 0
C(k) = p * (情况1) + (1-p) * (情况2)
将两种情况也用 C 代入,有:
C(k) = p*(1 + C(k–1)) + (1–p)*(1 + C(k))
C(k) = C(k–1) + 1/p
C(k) = k/p
上式表明,搜索时,平均在每层上需要搜索的路径长度为 1/2)。
又注意到,上小节我们知道跳表的最大层数为
P.S. 这里我们用到的是最大层数,原论文证明时用到的是
比起单纯的单链表,跳表需要存储多级索引,肯定要消耗更多的存储空间。那到底需要消耗多少额外的存储空间呢?
跳表的空间复杂度分析并不难,我在前面说了,假设原始链表大小为 n,那第一级索引大约有 n/2 个结点,第二级索引大约有 n/4 个结点,以此类推,每上升一级就减少一半,直到剩下 2 个结点。如果我们把每层索引的结点数写出来,就是一个等比数列。
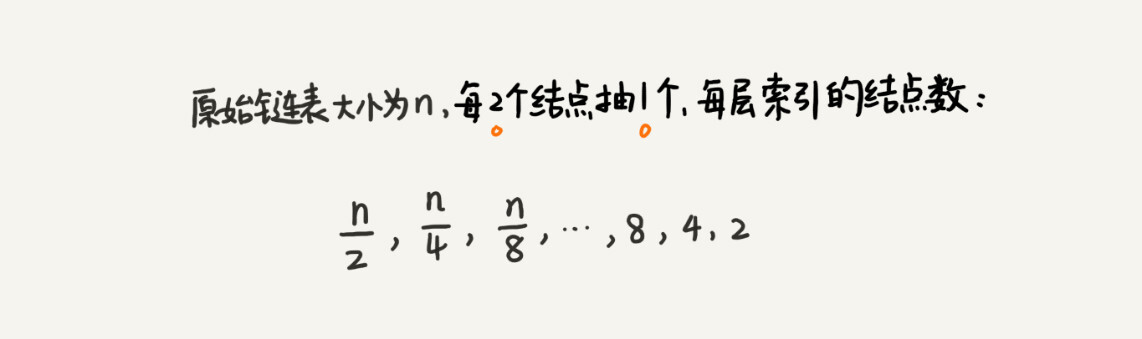
这几级索引的结点总和就是 n/2+n/4+n/8…+8+4+2=n-2。所以,跳表的空间复杂度是 O(n)。也就是说,如果将包含 n 个结点的单链表构造成跳表,我们需要额外再用接近 n 个结点的存储空间。那我们有没有办法降低索引占用的内存空间呢?
我们前面都是每两个结点抽一个结点到上级索引,如果我们每三个结点或五个结点,抽一个结点到上级索引,是不是就不用那么多索引结点了呢?我画了一个每三个结点抽一个的示意图,你可以看下。
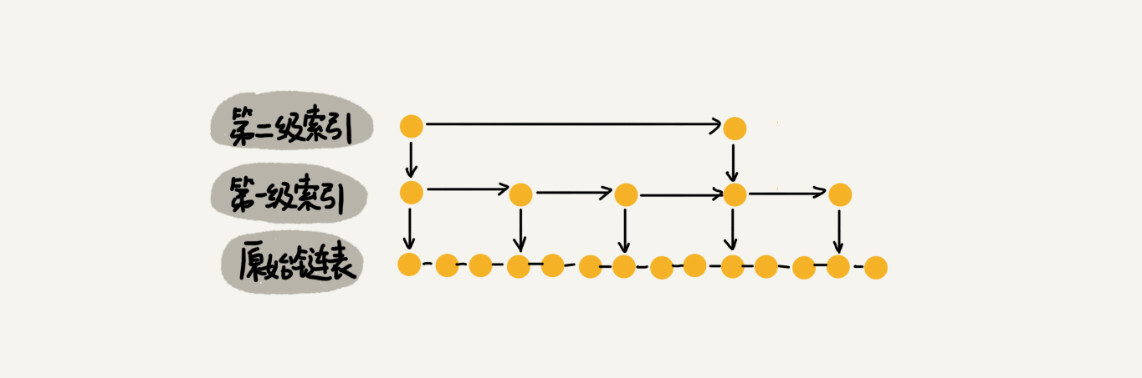
从图中可以看出,第一级索引需要大约 n/3 个结点,第二级索引需要大约 n/9 个结点。每往上一级,索引结点个数都除以 3。为了方便计算,我们假设最高一级的索引结点个数是 1。我们把每级索引的结点个数都写下来,也是一个等比数列。
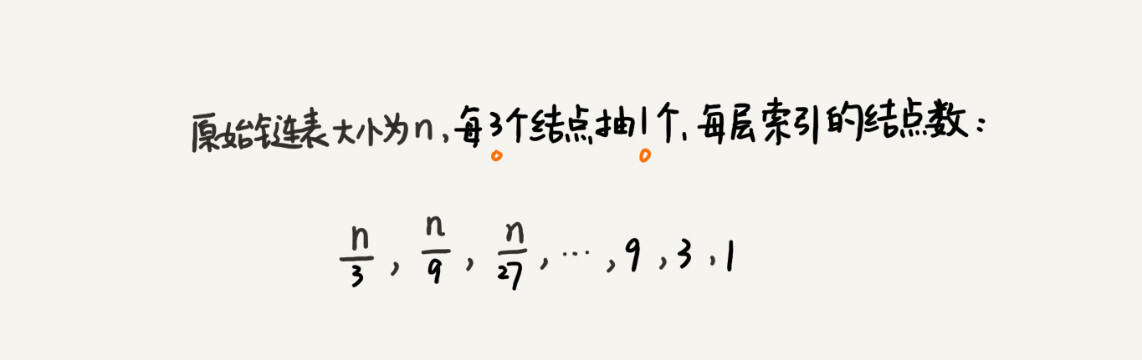
通过等比数列求和公式,总的索引结点大约就是 n/3+n/9+n/27+...+9+3+1=n/2。尽管空间复杂度还是 O(n),但比上面的每两个结点抽一个结点的索引构建方法,要减少了一半的索引结点存储空间。
实际上,在软件开发中,我们不必太在意索引占用的额外空间。在讲数据结构和算法时,我们习惯性地把要处理的数据看成整数,但是在实际的软件开发中,原始链表中存储的有可能是很大的对象,而索引结点只需要存储关键值和几个指针,并不需要存储对象,所以当对象比索引结点大很多时,那索引占用的额外空间就可以忽略了。
跳表长什么样子我想你应该已经很清楚了,它的查找操作我们刚才也讲过了。实际上,跳表这个动态数据结构,不仅支持查找操作,还支持动态的插入、删除操作,而且插入、删除操作的时间复杂度也是 O(logn)。
当我们不停地往跳表中插入数据时,如果我们不更新索引,就有可能出现某 2 个索引结点之间数据非常多的情况。极端情况下,跳表还会退化成单链表。
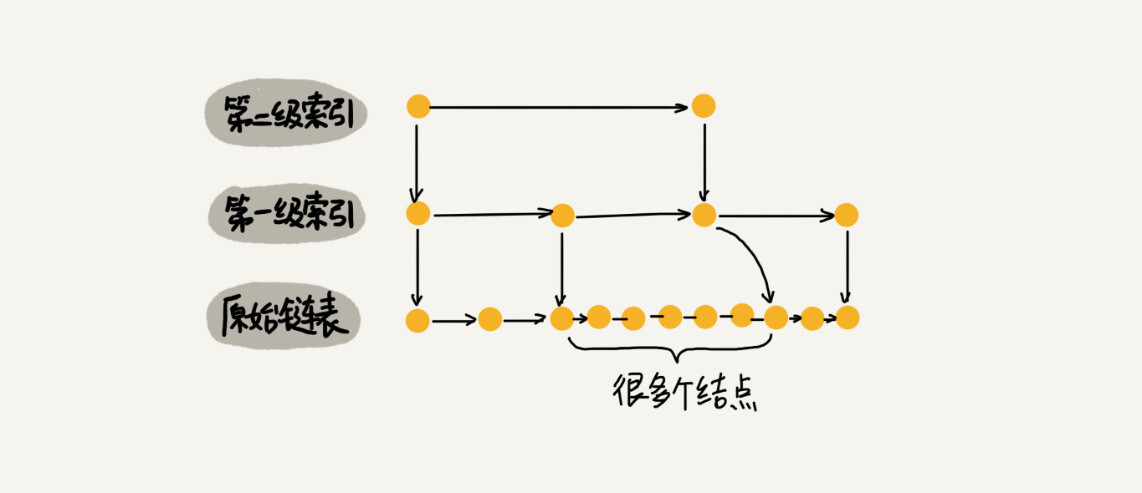
作为一种动态数据结构,我们需要某种手段来维护索引与原始链表大小之间的平衡,也就是说,如果链表中结点多了,索引结点就相应地增加一些,避免复杂度退化,以及查找、插入、删除操作性能下降。
如果你了解红黑树、AVL 树这样平衡二叉树,你就知道它们是通过左右旋的方式保持左右子树的大小平衡(如果不了解也没关系,我们后面会讲),而跳表是通过随机函数来维护前面提到的“平衡性”。
当我们往跳表中插入数据的时候,我们可以选择同时将这个数据插入到部分索引层中。如何选择加入哪些索引层呢?
我们通过一个随机函数,来决定将这个结点插入到哪几级索引中,比如随机函数生成了值 K,那我们就将这个结点添加到第一级到第 K 级这 K 级索引中。
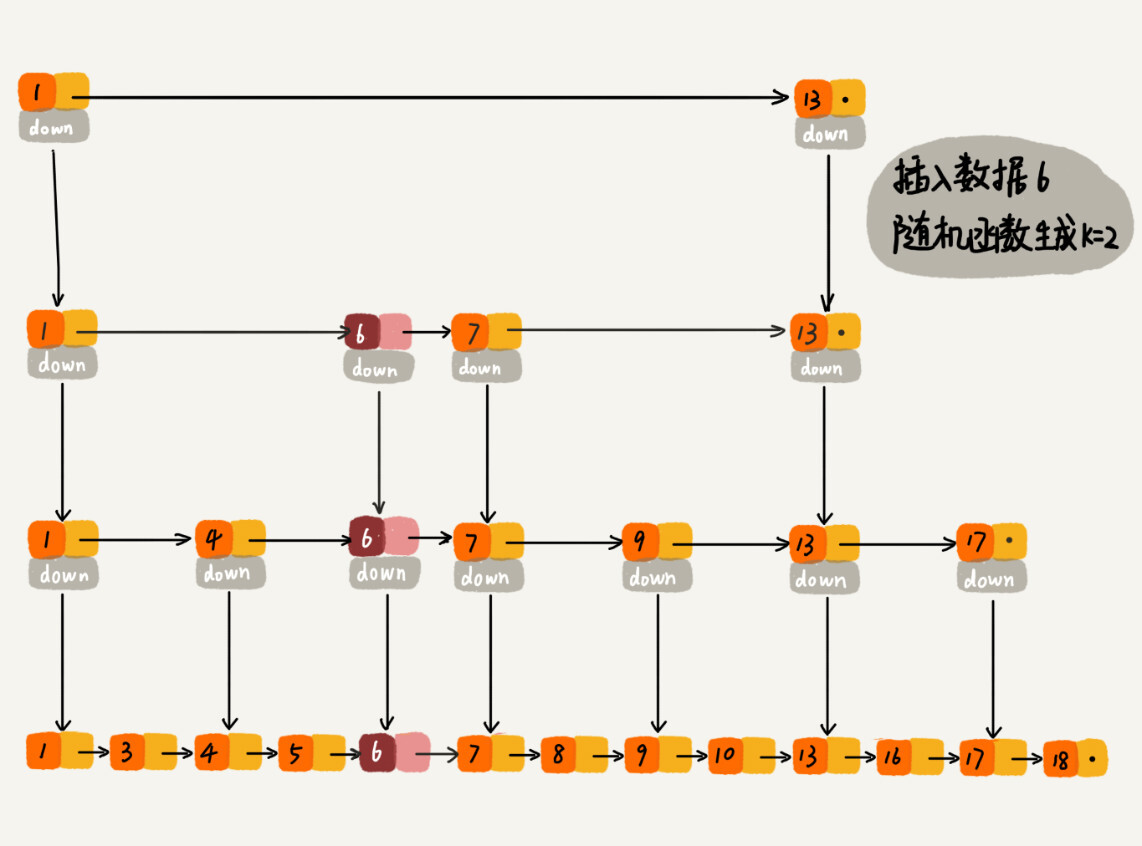
随机函数的选择很有讲究,从概率上来讲,能够保证跳表的索引大小和数据大小平衡性,不至于性能过度退化。至于随机函数的选择,我就不展开讲解了。
如果你感兴趣的话,可以看看我在 GitHub 上的代码或者 Redis 中关于有序集合的跳表实现。
为什么 Redis 要用跳表来实现有序集合,而不是红黑树?
Redis 中的有序集合是通过跳表来实现的,严格点讲,其实还用到了散列表。不过散列表我们后面才会讲到,所以我们现在暂且忽略这部分。
如果你去查看 Redis 的开发手册,就会发现,Redis 中的有序集合支持的核心操作主要有下面这几个:
- 插入一个数据;
- 删除一个数据;
- 查找一个数据;
- 按照区间查找数据(比如查找值在[100, 356]之间的数据);
- 迭代输出有序序列。
其中,插入、删除、查找以及迭代输出有序序列这几个操作,红黑树也可以完成,时间复杂度跟跳表是一样的。但是,按照区间来查找数据这个操作,红黑树的效率没有跳表高。
对于按照区间查找数据这个操作,跳表可以做到 O(logn) 的时间复杂度定位区间的起点,然后在原始链表中顺序往后遍历就可以了。这样做非常高效。
当然,Redis 之所以用跳表来实现有序集合,还有其他原因,比如,跳表更容易代码实现。虽然跳表的实现也不简单,但比起红黑树来说还是好懂、好写多了,而简单就意味着可读性好,不容易出错。还有,跳表更加灵活,它可以通过改变索引构建策略,有效平衡执行效率和内存消耗。
- 各种搜索结构提高效率的方式都是通过空间换时间得到的。
- 跳表最终形成的结构和搜索树很相似。
- 跳表通过随机的方式来决定新插入节点来决定索引的层数。
- 跳表搜索的时间复杂度是
$O(logn)$ ,插入/删除也是。
想到快排(quick sort)与其它排序算法(如归并排序/堆排序)虽然时间复杂度是一样的,但复杂度的常数项较小;跳表的原论文也说跳表能提供一个常数项的速度提升,因此想着常数项小是不是随机算法的一个特点?这也它们大放异彩的重要因素吧。
跳表使用空间换时间的设计思路,通过构建多级索引来提高查询的效率,实现了基于链表的“二分查找”。跳表是一种动态数据结构,支持快速地插入、删除、查找操作,时间复杂度都是 O(logn)。
- ftp://ftp.cs.umd.edu/pub/skipLists/skiplists.pdf 原论文
- https://ticki.github.io/blog/skip-lists-done-right/ skip list 的一些变种、优化
- https://eugene-eeo.github.io/blog/skip-lists.html skip list 的一些相关复杂度分析
- http://cglab.ca/~morin/teaching/5408/refs/p90b.pdf skip list cookbook,算是 skip list 各方面的汇总
- 一个可以在有序元素中实现快速查询的数据结构 包含 skip list 的 C++ 实现
- Redis内部数据结构详解(6)——skiplist 图文并茂讲解 skip list,可与本文交叉对照
- https://www.youtube.com/watch?v=2g9OSRKJuzM MIT 关于 skip list 的课程
- https://courses.csail.mit.edu/6.046/spring04/handouts/skiplists.pdf MIT 课程讲义