最大路径算法也是图算法,在前面也学到了图的两种算法,深度遍历算法和广度遍历算法。这两种算法都是针对无权图。那么针对有权图时,我们就要用到今天要学的最短路径算法,这种算法在地图软件经常使用,常用于路线规划方面。
算法建模,将复杂的场景抽象成简单的数据结构,那么在地图如何规划一个最短路径的算法的数据结构呢?
很显然我们用图是最合适不过了,我们可以把每个岔路口当作顶点,岔路口之间的距离可以当作边,路的长度就是边的权重了。如果是单行道,那就在两个岔路口画一个有向边,如果是双行道,那就画一个方面相反的有向边。这样整个地图就是一个有向有权图了。
代码实现:
public class Graph {
    private readonly List<Edge>[] _adjs; //邻接表
    private readonly int _v; //顶点

    public Graph(int v) {
        _v = v;
        _adjs = new List<Edge>[v];
        for (int i = 0; i < v; i++) {
            this._adjs[i] = new List<Edge>();
        }
    }
    //添加一条边
    public void AddEdge(int s, int d, int w) {
        _adjs[s].Add(new Edge(s, d, w));
    }

    private class Edge {
    private readonly int _start; //边的起始顶点
    private readonly int _end; //边的终止顶点
    private readonly int _w; //权重

    public Edge(int start, int end, int w) {
        _start = start;
        _end = end;
        _w = w;
    }

    public int Start => _start;
    public int End => _end;
    public int W => _w;
}两个顶点间的最短距离,最经典的算法就是单源最短路径算法,其中最出名就是 Dijkstra 算法。我们结合代码来看:
//从顶点s到顶点t的边(最短路径)
public void Dijkstra(int s, int t) {
    int[] predecessor = new int[_v]; //用来还原最短路径
    Vertex[] vertices = new Vertex[_v];
    for (int i = 0; i < _v; i++) {
        vertices[i] = new Vertex(i, int.MaxValue);
    }
    PriorityQueue<Vertex> queue = new PriorityQueue<Vertex>(_v);
    bool[] inqueue = new bool[_v];
    vertices[s].Dist = 0;
    queue.Push(vertices[s]);
    inqueue[s] = true;
    while (queue.Count > 0) {
        Vertex minVertex = queue.Pop(); //取堆顶元素并删除
        if (minVertex.ID == t) break; //最短路径产生
        for (int i = 0; i < _adjs[minVertex.ID].Count; ++i) {
            Edge edge = _adjs[minVertex.ID][i]; //取出于顶点相连的边
            Vertex nextVertex = vertices[edge.End]; //minVertex->nextVertex 边
            if (minVertex.Dist + edge.W < nextVertex.Dist) { //更新 nextVertex 的 dist
                nextVertex.Dist = minVertex.Dist + edge.W;
                predecessor[nextVertex.ID] = minVertex.ID;
                if (inqueue[nextVertex.ID] == true) {
                    queue.Update(nextVertex); //更新队列中的 dist 值
                } else {
                    queue.Push(nextVertex);
                    inqueue[nextVertex.ID] = true;
                }
            }
        }
    }
    //输出最短路径
    Console.WriteLine(s);
    Print(s, t, predecessor);
}
我们用 vertices 数组记录起始顶点和每个顶点的距离(dist),并把 vertices 初始化。我们把起始顶点初始化为 0 ,然后放到优先级队列中。由于我们这次求的是最短路径,所以我们这个优先级队列 PriorityQueue 使用的小顶堆实现的。
我们遍历优先级队列中的元素,取出 dist 距离最小的顶点 minVertex,然后考察这个顶点可达的所有顶点(代码中的 nextVertex)的距离。起点的 dist + minVertex 与 nextVertex 边的权重 w 看是否小于 nextVertex 的当前 dist 值,如果小于,则说明还有更近的路径经过顶点与 nextVertex,于是更新 nextVertex 的 dist 为 minVertex 的 dist 值 + 权重 w。然后我们把 nextVertex 存进优先级队列中,直到找到终点顶点或队列为空。
以上就是 Dijkstra 算法的核心思想,除此之外,还有两个变量,predecessor,inqueue。前者是用来打印出路径的,inqueue 是用来存储已经存近队列中的标识,避免重复存进队列中。
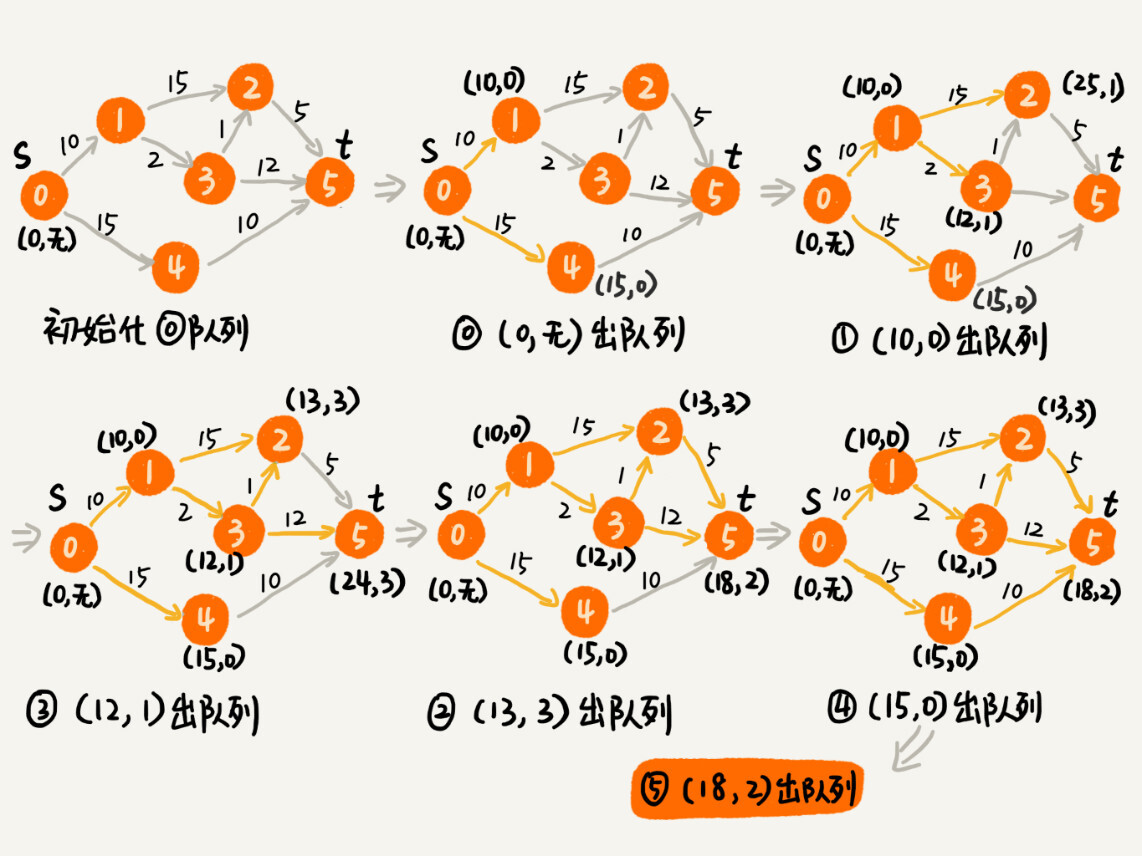
整个算法最耗时的部分就是 while 循环体, while 循环多少次我们可以得知最多循环所有的顶点个数,假设为 V,其中嵌套的 for 循环具体循环多少次我们还不确定,跟每个顶点的相邻的边的个数有关,E1,E2,...,En(n=V-1)。如果我们把所有的边加起来,最大也不会超过所有边的个数 E。
再来看优先级队列的相关的耗时操作,涉及到的操作有数据的插入,取数据以及更新数据(更新数据页包括查),因为队列是用堆实现的,所有相关的操作都是 O(logV)(堆的元素个数就是顶点个数 V)。
所有综合所述,在利用乘法原则,时间复杂度为 O(E*logV)。
到这里我们可以求两个顶点的最短距离了,但是我们试想一下,如果在一个很大的地图上我们求两个地点的最短距离,因为两个地点之间存在大量的分叉口和道路,对应到我们的有向带权图,就有非常多的顶点和边。如果我们再次基础上用 Dijkstra 算法明显会很耗时,那有什么优化方法么?
对于软件开发工程师来说,我们经常要根据问题的实际背景,对解决方案权衡取舍。类似出行路线这种工程上的问题,我们没有必要非得求出个绝对最优解。很多时候,为了兼顾执行效率,我们只需要计算出一个可行的次优解就可以了
根据这个原则,我们可以先可以在这个大范围的两个地点划分一个小的区域,然后求这个区域的两个地点用 Dijkstra 算法求最短距离。
不过也可能会碰到两个地点非常远,比如深圳到北京,这种情况包含的区域还是非常大。
这种情况,我们可以缩小这两个地点的地图,这样我们看到的就是区域其实就缩小了很多,然后划分这两个地点的为一个小的区域,也就是说先规划一个的大的出行线路,当我们方法地图时,才会细化到每个阶段的小的线路。我们平常用地图软件时,我们规划两个点距离时,也是先规划的大的线路,放大的时候才会具体到小的道路。
之前我们是求两个顶点的最短距离,那么如果分析两个地点的最短时间呢?其实我们只需要吧之前的每个顶点的边的代表距离的权值修改成时间的权值即可。
其实大多数地图算法都是用的 A+ 启发式搜索算法,不过也是在 Dijkstra 基础上的优化而已。
我们学了最短路径算法,实际上出了 Dijkstra 算法之外,还有 Bellford 算法以及 Floyd 算法,有兴趣会在后面继续学习。掌握了这种算法逻辑思想,我们可以拿来处理其他场景的问题,看似与地图毫无关系的问题。
比如要做一个翻译系统,如果要翻译一个句子,我们要将句子拆成一个个单词,在丢给单词系统。针对每个单词,有不同的意思,所以翻译系统会翻译出几种结果出来,并且对每个翻译打一个分,代表翻译的精准度。
针对整个句子的翻,我希望得到前 K 个翻译得分最高的结果,那么如何实现呢?
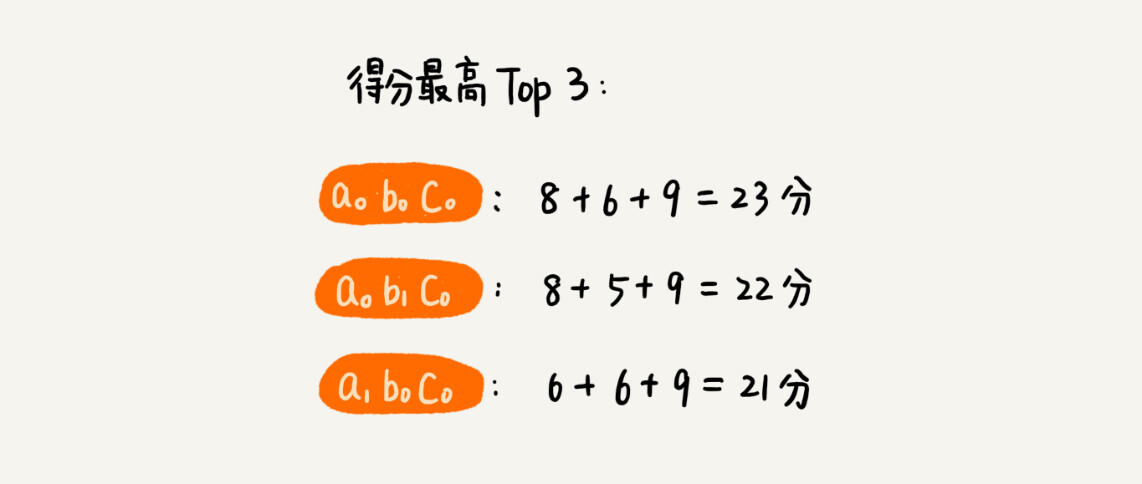
当然这种方法可以借助回溯法,这个姑且不做考虑,实际上我们可以用 Dijkstra 算法。把每个单词的可选翻译按照分数从大到小排序,所以 a0b0c0 分数是最高的组合翻译结果。我们把这个结果作为一个对象放到优先级队列中。
我们每次从优先级队列中取出最高分数的组合,然后在此基础之上拓展下一个单词翻译。比如 a0b0c0 拓展后会得到 a1b0c0,a0b1c0,a0b0c1。我们把拓展后的组合结果作为对象存储到优先级队列中。直到得到前 K 个分数最高的结果或遍历完所有的结果(队列为空)。
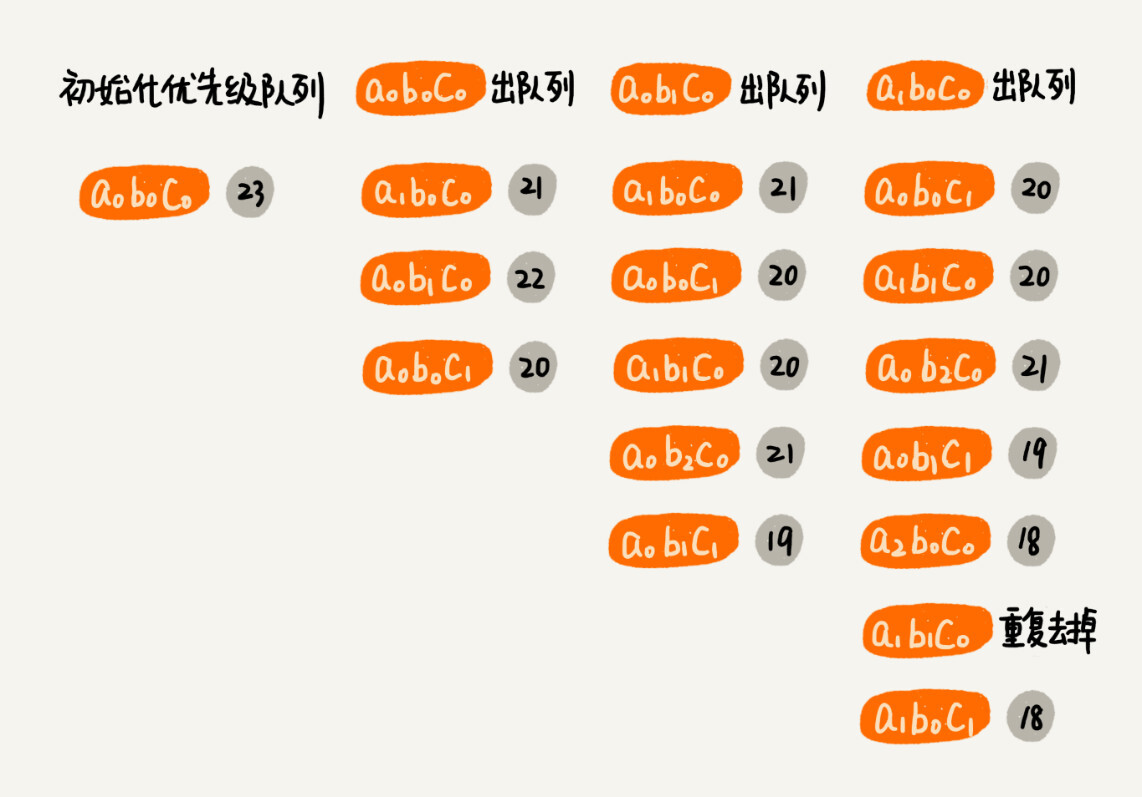
如果用回溯的话,时间复杂度为指数级别 O(mn) m 为单词个数,n 为翻译的个数。如果用 Dijkstra 算法之后呢?我们要求得前 k 个结果,就意味有 k 次取出队列操作。每次有一个组合出队列,就意味有 n 个组合入队列。优先级队列的如队列和出队列的时间复杂度都是 O(logX),X 代表队列中的元素个数。所以总的时间复杂度为 O(k*n*logX)。那 X 到底是多少呢?
k 次出队列,总的数据不会超过 kn,也就是说每次入队列和出队列都是 O(logk*n),所以总的时间复杂为 O(k**nlog(kn))。性能明显提高了