| title | 手撕 JVM 面试 | |
|---|---|---|
| date | 2024-05-31 | |
| tags |
|
|
| categories | JVM |

为啥 java 不用 360 进行垃圾回收? 为啥 java 不用 360 进行垃圾回收? 哈哈哈哈~
开玩笑,言归正传。 背诵一下G1 垃圾回收方法类的第 108 行?
。。。。。。。。。。。。。。。。。。。
Java 语言是一种具有动态性的解释型语言,类(Class)只有被加载到 JVM 后才能运行。当运行指定程序时,JVM 会将编译生成的 .class 文件按照需求和一定的规则加载到内存中,并组织成为一个完整的 Java 应用程序。这个加载过程是由类加载器完成,具体来说,就是由 ClassLoader 和它的子类来实现的。类加载器本身也是一个类,其实质是把类文件从硬盘读取到内存中。
类的加载方式分为隐式加载和显示加载。隐式加载指的是程序在使用 new 等方式创建对象时,会隐式地调用类的加载器把对应的类 加载到 JVM 中。显示加载指的是通过直接调用 class.forName() 方法来把所需的类加载到 JVM 中。
任何一个工程项目都是由许多类组成的,当程序启动时,只把需要的类加载到 JVM 中,其他类只有被使用到的时候才会被加载,采用这种方法一方面可以加快加载速度,另一方面可以节约程序运行时对内存的开销。此外,在 Java 语言中,每个类或接口都对应一个 .class文件,这些文件可以被看成是一个个可以被动态加载的单元,因此当只有部分类被修改时,只需要重新编译变化的类即可, 而不需要重新编译所有文件,因此加快了编译速度。
Java 虚拟机把描述类的数据从 Class 文件加载到内存,并对数据进行校验、转换解析和初始化,最终形成可以被虚拟机直接使用的 Java 类型,这就是虚拟机的加载机制。
类从被加载到虚拟机内存中开始,到卸载出内存为止,它的整个生命周期包括:加载、验证、准备、解析、初始化、使用和卸载七个阶段。(验证、准备和解析又统称为连接,为了支持Java语言的运行时绑定,所以解析阶段也可以是在初始化之后进行的。以上顺序都只是说开始的顺序,实际过程中是交叉的混合式进行的,加载过程中可能就已经开始验证了)

类加载器就是做上边提到的类加载过程的一个东西~
类加载器的任务是根据一个类的全限定名来读取此类的二进制字节流到 JVM 中,然后转换为一个与目标类对应的 java.lang.Class 对象实例
- 这个类加载使用 C/C++ 语言实现,嵌套在 JVM 内部
- 它用来加载 Java 的核心库(
JAVA_HOME/jre/lib/rt.jar、resource.jar或sun.boot.class.path路径下的内容),用于提供 JVM 自身需要的类 - 并不继承自
java.lang.ClassLoader,没有父加载器 - 加载扩展类和应用程序类加载器,并指定为他们的父类加载器
- 出于安全考虑,Bootstrap 启动类加载器只加载名为java、Javax、sun等开头的类
- Java 语言编写,由
sun.misc.Launcher$ExtClassLoader实现 - 派生于 ClassLoader
- 父类加载器为启动类加载器
- 从
java.ext.dirs系统属性所指定的目录中加载类库,或从 JDK 的安装目录的jre/lib/ext子目录(扩展目录)下加载类库。如果用户创建的 JAR 放在此目录下,也会自动由扩展类加载器加载
- Java 语言编写,由
sun.misc.Lanucher$AppClassLoader实现 - 派生于 ClassLoader
- 父类加载器为扩展类加载器
- 它负责加载环境变量
classpath或系统属性java.class.path指定路径下的类库 - 该类加载是程序中默认的类加载器,一般来说,Java 应用的类都是由它来完成加载的
- 通过
ClassLoader#getSystemClassLoader()方法可以获取到该类加载器

在 Java 的日常应用程序开发中,类的加载几乎是由 3 种类加载器相互配合执行的,在必要时,我们还可以自定义类加载器,来定制类的加载方式
- 隔离加载类
- 修改类加载的方式
- 扩展加载源(可以从数据库、云端等指定来源加载类)
- 防止源码泄露(Java 代码容易被反编译,如果加密后,自定义加载器加载类的时候就可以先解密,再加载)
如果你自定义了一个 String 类型的数据,那么系统会加载哪个 String 取决于几个因素:
- 作用域(Scope):
- 如果自定义的
String位于局部作用域内(例如一个方法内部),那么这个局部变量将会被优先使用。 - 如果自定义的
String位于类的成员变量或者全局变量,那么在该类或全局范围内会优先使用这个自定义的String。
- 如果自定义的
- 类加载顺序:
- 如果你在某个类中自定义了一个名为
String的类型,这个自定义的类型会在该类的上下文中被优先加载。 - 通常来说,标准库中的
java.lang.String会在默认情况下被加载使用,但如果你定义了一个同名类且在当前作用域内,这个自定义的类会覆盖标准库中的类。
- 如果你在某个类中自定义了一个名为
- 包的使用:
- 如果你的自定义
String类型在某个特定的包中,而标准库的java.lang.String是在java.lang包中,那么在不明确指定包名的情况下,当前作用域内的类型会优先被加载。 - 可以通过完全限定名(Fully Qualified Name)来区分,例如使用
java.lang.String来确保使用的是标准库中的String。
- 如果你的自定义
以下是一个示例来说明作用域和类加载的情况:
public class MyClass {
    // 自定义的String类
    public static class String {
        public void print() {
            System.out.println("This is my custom String class.");
        }
    }

    public static void main(String[] args) {
        // 使用自定义的String类
        String myString = new String();
        myString.print(); // 输出: This is my custom String class.

        // 使用标准库的String类
        java.lang.String standardString = new java.lang.String("Hello, World!");
        System.out.println(standardString); // 输出: Hello, World!
    }
}
在这个示例中:
mypackage.MyClass.String是自定义的String类,并在main方法中优先使用。java.lang.String是标准库中的String类,通过完全限定名确保其正确加载。
综上所述,系统会加载哪个 String,取决于你的自定义 String 在代码中的定义位置和使用范围。如果你明确指定了完全限定名,那么系统会准确加载你指定的那个 String 类。
针对 java.*开头的类,jvm 的实现中已经保证了必须由 bootstrp 来加载
双亲委派

Java 虚拟机对 class 文件采用的是按需加载的方式,也就是说当需要使用该类的时候才会将它的 class 文件加载到内存生成 class 对象。而且加载某个类的 class 文件时,Java 虚拟机采用的是双亲委派模式,即把请求交给父类处理,它是一种任务委派模式。
简单说就是当类加载器(Class-Loader)试图加载某个类型的时候,除非父加载器找不到相应类型,否则尽量将这个任务代理给当前加载器的父加载器去做。使用委派模型的目的是避免重复加载 Java 类型。
工作过程
- 如果一个类加载器收到了类加载请求,它并不会自己先去加载,而是把这个请求委托给父类的加载器去执行;
- 如果父类加载器还存在其父类加载器,则进一步向上委托,依次递归,请求最终将到达顶层的启动类加载器;
- 如果父类加载器可以完成类加载任务,就成功返回,倘若父类加载器无法完成此加载任务,子加载器才会尝试自己去加载,这就是双亲委派模式
优势
- 避免类的重复加载,JVM 中区分不同类,不仅仅是根据类名,相同的 class 文件被不同的 ClassLoader 加载就属于两个不同的类(比如,Java中的Object类,无论哪一个类加载器要加载这个类,最终都是委派给处于模型最顶端的启动类加载器进行加载,如果不采用双亲委派模型,由各个类加载器自己去加载的话,系统中会存在多种不同的 Object 类)
- 保护程序安全,防止核心 API 被随意篡改,避免用户自己编写的类动态替换 Java 的一些核心类,比如我们自定义类:
java.lang.String
三个类加载器的关系,不是父子关系,是组合关系。
看看类加载器的加载类的方法 loadClass
protected Class<?> loadClass(String name, boolean resolve)
  throws ClassNotFoundException
{
  //看,这里有锁
  synchronized (getClassLoadingLock(name)) {
    // First, check if the class has already been loaded
    //去看看类是否被加载过,如果被加载过,就立即返回
    Class<?> c = findLoadedClass(name);
    if (c == null) {
      long t0 = System.nanoTime();
      try {
        //这里通过是否有parent来区分启动类加载器和其他2个类加载器
        if (parent != null) {
          //先尝试请求父类加载器去加载类,父类加载器加载不到,再去尝试自己加载类
          c = parent.loadClass(name, false);
        } else {
          //启动类加载器加载类,本质是调用c++的方法
          c = findBootstrapClassOrNull(name);
        }
      } catch (ClassNotFoundException e) {
        // ClassNotFoundException thrown if class not found
        // from the non-null parent class loader
      }
      //如果父类加载器加载不到类,子类加载器再尝试自己加载
      if (c == null) {
        // If still not found, then invoke findClass in order
        // to find the class.
        long t1 = System.nanoTime();
        //加载类
        c = findClass(name);

        // this is the defining class loader; record the stats
        sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0);
        sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
        sun.misc.PerfCounter.getFindClasses().increment();
      }
    }
    if (resolve) {
      resolveClass(c);
    }
    return c;
  }
}
总结一下loadClass方法的大概逻辑:
- 首先加锁,防止多线程的情况下,重复加载同一个类
- 当加载类的时候,先请求其父类加载器去加载类,如果父类加载器无法加载类时,才自己尝试去加载类。

上面的源码解析,可以回答问题:在多线程的情况下,类的加载为什么不会出现重复加载的情况?
- 双亲委派模型并不是一个强制性的约束模型,而是 Java 设计者推荐给开发者的类加载器实现方式,可以“被破坏”,只要我们自定义类加载器,重写
loadClass()方法,指定新的加载逻辑就破坏了,重写findClass()方法不会破坏双亲委派。 - 双亲委派模型有一个问题:顶层 ClassLoader,无法加载底层 ClassLoader 的类。典型例子 JNDI、JDBC,所以加入了线程上下文类加载器(Thread Context ClassLoader),可以通过
Thread.setContextClassLoaser()设置该类加载器,然后顶层 ClassLoader 再使用Thread.getContextClassLoader()获得底层的 ClassLoader 进行加载。 - Tomcat 中使用了自定义 ClassLoader,并且也破坏了双亲委托机制。每个应用使用 WebAppClassloader 进行单独加载,他首先使用 WebAppClassloader 进行类加载,如果加载不了再委托父加载器去加载,这样可以保证每个应用中的类不冲突。每个 tomcat 中可以部署多个项目,每个项目中存在很多相同的 class 文件(很多相同的jar包),他们加载到 jvm 中可以做到互不干扰。
- 利用破坏双亲委派来实现代码热替换(每次修改类文件,不需要重启服务)。因为一个 Class 只能被一个 ClassLoader 加载一次,否则会报
java.lang.LinkageError。当我们想要实现代码热部署时,可以每次都 new 一个自定义的 ClassLoader 来加载新的 Class文件。JSP 的实现动态修改就是使用此特性实现。

通常可以把 JVM 内存区域分为下面几个方面,其中,有的区域是以线程为单位,而有的区域则是整个 JVM 进程唯一的。
首先,程序计数器(PC,Program Counter Register)。在 JVM 规范中,每个线程都有它自己的程序计数器,并且任何时间一个线程都只有一个方法在执行,也就是所谓的当前方法。程序计数器会存储当前线程正在执行的 Java 方法的 JVM 指令地址;或者,如果是在执行本地方法,则是未指定值(undefined)。
第二,Java 虚拟机栈(Java Virtual Machine Stack),早期也叫 Java 栈。每个线程在创建时都会创建一个虚拟机栈,其内部保存一个个的栈帧(Stack Frame),对应着一次次的 Java 方法调用。
前面谈程序计数器时,提到了当前方法;同理,在一个时间点,对应的只会有一个活动的栈帧,通常叫作当前帧,方法所在的类叫作当前类。如果在该方法中调用了其他方法,对应的新的栈帧会被创建出来,成为新的当前帧,一直到它返回结果或者执行结束。JVM 直接对 Java 栈的操作只有两个,就是对栈帧的压栈和出栈。
栈帧中存储着局部变量表、操作数(operand)栈、动态链接、方法正常退出或者异常退出的定义等。
第三,堆(Heap),它是 Java 内存管理的核心区域,用来放置 Java 对象实例,几乎所有创建的 Java 对象实例都是被直接分配在堆上。堆被所有的线程共享,在虚拟机启动时,我们指定的“Xmx”之类参数就是用来指定最大堆空间等指标。
理所当然,堆也是垃圾收集器重点照顾的区域,所以堆内空间还会被不同的垃圾收集器进行进一步的细分,最有名的就是新生代、老年代的划分。
第四,方法区(Method Area)。这也是所有线程共享的一块内存区域,用于存储所谓的元(Meta)数据,例如类结构信息,以及对应的运行时常量池、字段、方法代码等。
由于早期的 Hotspot JVM 实现,很多人习惯于将方法区称为永久代(Permanent Generation)。Oracle JDK 8 中将永久代移除,同时增加了元数据区(Metaspace)。
第五,运行时常量池(Run-Time Constant Pool),这是方法区的一部分。如果仔细分析过反编译的类文件结构,你能看到版本号、字段、方法、超类、接口等各种信息,还有一项信息就是常量池。Java 的常量池可以存放各种常量信息,不管是编译期生成的各种字面量,还是需要在运行时决定的符号引用,所以它比一般语言的符号表存储的信息更加宽泛。
第六,本地方法栈(Native Method Stack)。它和 Java 虚拟机栈是非常相似的,支持对本地方法的调用,也是每个线程都会创建一个。在 Oracle Hotspot JVM 中,本地方法栈和 Java 虚拟机栈是在同一块儿区域,这完全取决于技术实现的决定,并未在规范中强制。
- 直接内存(Direct Memory)区域, Direct Buffer 所直接分配的内存,也是个容易出现问题的地方。尽管,在 JVM 工程师的眼中,并不认为它是 JVM 内部内存的一部分,也并未体现 JVM 内存模型中。
- JVM 本身是个本地程序,还需要其他的内存去完成各种基本任务,比如,JIT Compiler 在运行时对热点方法进行编译,就会将编译后的方法储存在 Code Cache 里面;GC 等功能需要运行在本地线程之中,类似部分都需要占用内存空间。这些是实现 JVM JIT 等功能的需要,但规范中并不涉及。
在 Java8 中,永久代被移除,被一个称为元空间的区域代替,元空间的本质和永久代类似,都是方法区的实现。
元空间(Java8)和永久代(Java7)之间最大的区别就是:永久代使用的 JVM 的堆内存,Java8 以后的元空间并不在虚拟机中而是使用本机物理内存。
因此,默认情况下,元空间的大小仅受本地内存限制。类的元数据放入 natice memory,字符串池和类的静态变量放入堆中。
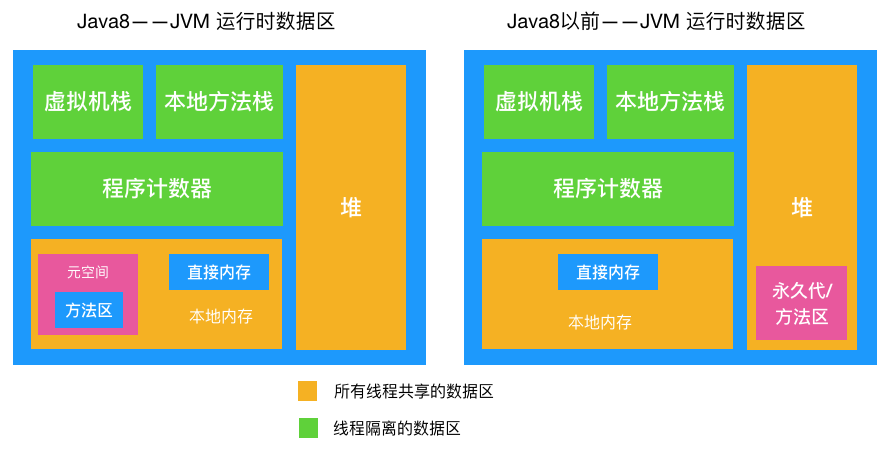
-
新生代
新生代是大部分对象创建和销毁的区域,在通常的 Java 应用中,绝大部分对象生命周期都是很短暂的。其内部又分为 Eden 区域,作为对象初始分配的区域;两个 Survivor,有时候也叫 from、to 区域,被用来放置从 Minor GC 中保留下来的对象。
-
JVM 会随意选取一个 Survivor 区域作为“to”,然后会在 GC 过程中进行区域间拷贝,也就是将 Eden 中存活下来的对象和 from 区域的对象,拷贝到这个“to”区域。这种设计主要是为了防止内存的碎片化,并进一步清理无用对象。
-
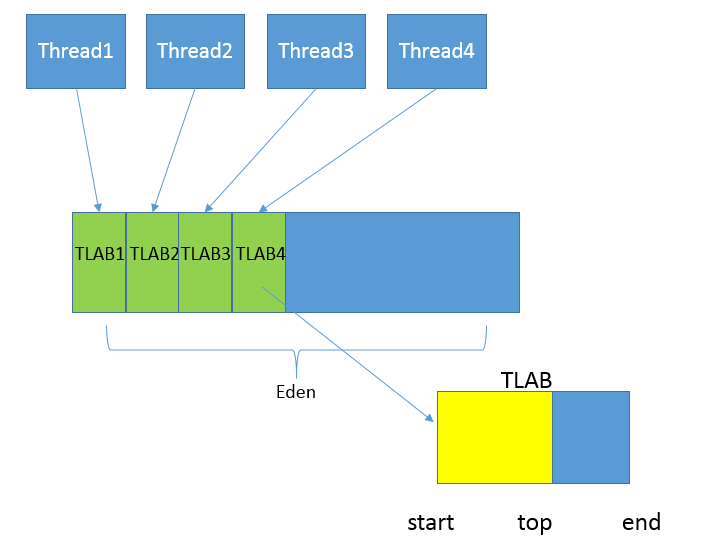
从内存模型而不是垃圾收集的角度,对 Eden 区域继续进行划分,Hotspot JVM 还有一个概念叫做 Thread Local Allocation Buffer(TLAB),据我所知所有 OpenJDK 衍生出来的 JVM 都提供了 TLAB 的设计。这是 JVM 为每个线程分配的一个私有缓存区域,否则,多线程同时分配内存时,为避免操作同一地址,可能需要使用加锁等机制,进而影响分配速度,你可以参考下面的示意图。从图中可以看出,TLAB 仍然在堆上,它是分配在 Eden 区域内的。其内部结构比较直观易懂,start、end 就是起始地址,top(指针)则表示已经分配到哪里了。所以我们分配新对象,JVM 就会移动 top,当 top 和 end 相遇时,即表示该缓存已满,JVM 会试图再从 Eden 里分配一块儿。
-
老年代
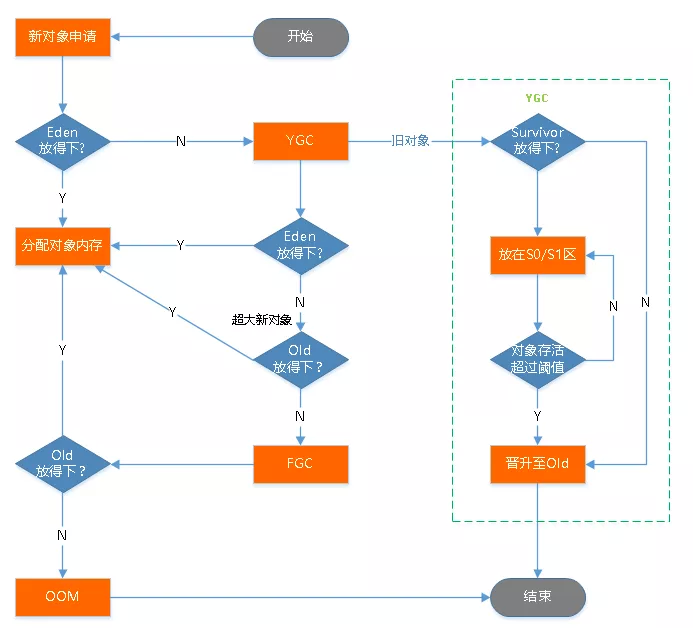
放置长生命周期的对象,通常都是从 Survivor 区域拷贝过来的对象。当然,也有特殊情况,我们知道普通的对象会被分配在 TLAB 上;如果对象较大,JVM 会试图直接分配在 Eden 其他位置上;如果对象太大,完全无法在新生代找到足够长的连续空闲空间,JVM 就会直接分配到老年代。
-
永久代
这部分就是早期 Hotspot JVM 的方法区实现方式了,储存 Java 类元数据、常量池、Intern 字符串缓存,在 JDK 8 之后就不存在永久代这块儿了。
-
-
- 默认的,新生代 ( Young ) 与老年代 ( Old ) 的比例的值为 1:2 ,可以通过参数 –XX:NewRatio 配置。
- 默认的,Edem : from : to = 8 : 1 : 1 ( 可以通过参数 –XX:SurvivorRatio 来设定)
- Survivor区中的对象被复制次数为15(对应虚拟机参数 -XX:+MaxTenuringThreshold)
- 如果没有Survivor,Eden区每进行一次Minor GC,存活的对象就会被送到老年代。老年代很快被填满,触发Major GC。老年代的内存空间远大于新生代,进行一次 Full GC 消耗的时间比 Minor GC 长得多,所以需要分为 Eden 和 Survivor。
- Survivor 的存在意义,就是减少被送到老年代的对象,进而减少 Full GC 的发生
- 设置两个 Survivor 区最大的好处就是解决了碎片化,刚刚新建的对象在 Eden 中,经历一次 Minor GC,Eden 中的存活对象就会被移动到第一块 survivor space S0,Eden 被清空;等 Eden 区再满了,就再触发一次 Minor GC,Eden 和 S0 中的存活对象又会被复制送入第二块 survivor space S1(这个过程非常重要,因为这种复制算法保证了S1中来自S0和Eden两部分的存活对象占用连续的内存空间,避免了碎片化的发生)
JVM 的一些高级优化技术,例如逃逸分析(Escape Analysis),可以使对象在栈上分配内存,而不是堆上。逃逸分析可以判断对象的作用域,如果确定对象不会逃逸出方法(即对象仅在方法内部使用),JVM 可以选择将对象分配在栈上。这种优化减少了垃圾回收的负担,并提高了性能。
我注意到有一些观点,认为通过逃逸分析,JVM 会在栈上分配那些不会逃逸的对象,这在理论上是可行的,但是取决于 JVM 设计者的选择。据我所知,Oracle Hotspot JVM 中并未这么做,这一点在逃逸分析相关的文档里已经说明,所以可以明确所有的对象实例都是创建在堆上。
- 目前很多书籍还是基于 JDK 7 以前的版本,JDK 已经发生了很大变化,Intern 字符串的缓存和静态变量曾经都被分配在永久代上,而永久代已经被元数据区取代。但是,Intern 字符串缓存和静态变量并不是被转移到元数据区,而是直接在堆上分配,所以这一点同样符合前面一点的结论:对象实例都是分配在堆上。
Java 在 new 一个对象的时候,会先查看对象所属的类有没有被加载到内存,如果没有的话,就会先通过类的全限定名来加载。加载并初始化类完成后,再进行对象的创建工作。
我们先假设是第一次使用该类,这样的话 new 一个对象就可以分为两个过程:加载并初始化类和创建对象
加载过程就是 ClassLoader 那一套:加载-验证-准备-解析-初始化
首先,JVM 会检查该类是否已经加载、连接和初始化。如果类尚未加载,JVM 会通过类加载器加载类文件并执行以下步骤:
加载(Loading):从类文件中读取字节码,将其加载到内存中。
连接(Linking):
- 验证(Verification):确保类的字节码符合 JVM 规范。
准备(Preparation):为类的静态变量分配内存并设置默认值。
解析(Resolution):将类的符号引用替换为直接引用。
初始化(Initialization):执行类的静态初始化块和静态变量的初始化。
然后创建对象
-
分配内存
一旦类被加载并初始化,JVM 会为新的对象分配内存。内存分配通常发生在堆上。内存分配的方式有以下两种主要方式:
- 指针碰撞(Pointer Bumping):如果堆内存是规整的,没有碎片,JVM 会通过移动一个指针来分配内存。
- 空闲列表(Free List):如果堆内存有碎片,JVM 会通过维护一个空闲列表来找到合适的内存块进行分配。
-
初始化分配的内存【对所有实例变量赋默认值】
分配内存后,JVM 会将该内存块清零(零值初始化),以确保对象的实例变量有默认值(如
0、null等)。 -
设置对象头
JVM 会在分配的内存中设置对象头(Object Header),包括以下信息:
- Mark Word:用于存储对象的哈希码、GC 分代年龄、锁状态标志等。
- Class Pointer:指向对象的类元数据,表示该对象是哪个类的实例。
-
执行构造方法
初始化顺序是先初始化父类再初始化子类,初始化时先执行实例代码块然后是构造方法
在内存分配和对象头设置完成后,JVM 会调用构造方法来初始化对象。构造方法的执行过程如下:
- 显式调用父类构造方法:如果没有显式调用,默认会调用父类的无参构造方法。
- 按声明顺序初始化实例变量:执行实例变量的初始化。
- 执行构造方法体:执行构造方法中的代码。
public class MyClass {
    private int x = 10; // 实例变量初始化

    public MyClass() {
        x = 20; // 构造方法体
    }
}

public class Test {
    public static void main(String[] args) {
        MyClass obj = new MyClass(); // new 关键字创建对象
    }
}在上述代码中,new MyClass() 过程包括:类加载检查、内存分配、内存初始化、对象头设置、实例变量初始化、调用构造方法。
-
返回对象引用
对象初始化完成后,
new关键字会返回对象的引用,并将其赋值给相应的变量。
OOM 如果通俗点儿说,就是 JVM 内存不够用了,javadoc 中对OutOfMemoryError的解释是,没有空闲内存,并且垃圾收集器也无法提供更多内存。
这里面隐含着一层意思是,在抛出 OutOfMemoryError 之前,通常垃圾收集器会被触发,尽其所能去清理出空间
当然,也不是在任何情况下垃圾收集器都会被触发的,比如,我们去分配一个超大对象,类似一个超大数组超过堆的最大值,JVM 可以判断出垃圾收集并不能解决这个问题,所以直接抛出 OutOfMemoryError。
从数据区的角度,除了程序计数器,其他区域都有可能会因为可能的空间不足发生 OutOfMemoryError,简单总结如下:
- 堆内存不足是最常见的 OOM 原因之一,抛出的错误信息是“java.lang.OutOfMemoryError:Java heap space”,原因可能千奇百怪,例如,可能存在内存泄漏问题;也很有可能就是堆的大小不合理,比如我们要处理比较可观的数据量,但是没有显式指定 JVM 堆大小或者指定数值偏小;或者出现 JVM 处理引用不及时,导致堆积起来,内存无法释放等。
- 而对于 Java 虚拟机栈和本地方法栈,这里要稍微复杂一点。如果我们写一段程序不断的进行递归调用,而且没有退出条件,就会导致不断地进行压栈。类似这种情况,JVM 实际会抛出 StackOverFlowError;当然,如果 JVM 试图去扩展栈空间的的时候失败,则会抛出 OutOfMemoryError。
- 对于老版本的 Oracle JDK,因为永久代的大小是有限的,并且 JVM 对永久代垃圾回收(如,常量池回收、卸载不再需要的类型)非常不积极,所以当我们不断添加新类型的时候,永久代出现 OutOfMemoryError 也非常多见,尤其是在运行时存在大量动态类型生成的场合;类似 Intern 字符串缓存占用太多空间,也会导致 OOM 问题。对应的异常信息,会标记出来和永久代相关:“java.lang.OutOfMemoryError: PermGen space”。
- 随着元数据区的引入,方法区内存已经不再那么窘迫,所以相应的 OOM 有所改观,出现 OOM,异常信息则变成了:“java.lang.OutOfMemoryError: Metaspace”。
- 直接内存不足,也会导致 OOM
-
内存泄露 memory leak,是指程序在申请内存后,无法释放已申请的内存空间,一次内存泄露危害可以忽略,但内存泄露堆积后果很严重,无论多少内存,迟早会被占光。
-
内存溢出 out of memory,是指程序在申请内存时,没有足够的内存空间供其使用,出现 out of memory;比如申请了一个 integer,但给它存了 long 才能存下的数,那就是内存溢出。
memory leak 最终会导致 out of memory!
Java 的内存泄漏问题比较难以定位,下面针对一些常见的内存泄漏场景做介绍:
- 持续在堆上创建对象而不释放。例如,持续不断的往一个列表中添加对象,而不对列表清空。这种问题,通常可以给程序运行时添加 JVM 参数
-Xmx指定一个较小的运行堆大小,这样可以比较容易的发现这类问题。 - 不正确的使用静态对象。因为 static 关键字修饰的对象的生命周期与 Java 程序的运行周期是一致的,所以垃圾回收机制无法回收静态变量引用的对象。所以,发生内存泄漏问题时,我们要着重分析所有的静态变量。
- 对大 String 对象调用
String.intern()方法,该方法会从字符串常量池中查询当前字符串是否存在,若不存在就会将当前字符串放入常量池中。而在 jdk6 之前,字符串常量存储在PermGen区的,但是默认情况下PermGen区比较小,所以较大的字符串调用此方法,很容易会触发内存溢出问题。 - 打开的输入流、连接没有正确关闭。由于这些资源需要对应的内存维护状态,因此不关闭会导致这些内存无法释放。
Java 的内存泄漏定位一般是比较困难的,需要使用到很多的实践经验和调试技巧。下面是一些比较通用的方法:
- 可以添加
-verbose:gc启动参数来输出 GC 日志。通过分析这些日志,可以知道每次 GC 后内存是否有增加,如果在缓慢的增加,那就有可能是内存泄漏了(当然也需要结合当前的负载)。如果无法添加这个启动参数,也可以使用 jstat 来查看实时的 gc 日志。如果有条件运行的化可以考虑使用 jvisualvm 图形化的观察,不过要是线上一般没这个条件。 - 当通过 dump 出堆内存,然后使用 jvisualvm 查看分析,一般能够分析出内存中大量存在的对象以及它的类型等。我们可以通过添加
-XX:+HeapDumpOnOutOfMemoryError启动参数来自动保存发生OOM时的内存dump。 - 当确定出大对象,或者大量存在的实例类型以后,我们就需要去review代码,从实际的代码入手来定位到真正发生泄漏的代码。
每个栈帧(Stack Frame)中存储着:
- 局部变量表(Local Variables)
- 操作数栈(Operand Stack)(或称为表达式栈)
- 动态链接(Dynamic Linking):指向运行时常量池的方法引用
- 方法返回地址(Return Address):方法正常退出或异常退出的地址
- 一些附加信息
- 栈是线程私有的,他的生命周期与线程相同,每个方法在执行的时候都会创建一个栈帧,用来存储局部变量表,操作数栈,动态链接,方法出口等信息。局部变量表又包含基本数据类型,对象引用类型
- 如果线程请求的栈深度大于虚拟机所允许的最大深度,将抛出StackOverflowError异常,方法递归调用产生这种结果。
- 如果 Java 虚拟机栈可以动态扩展,并且扩展的动作已经尝试过,但是无法申请到足够的内存去完成扩展,或者在新建立线程的时候没有足够的内存去创建对应的虚拟机栈,那么 Java 虚拟机将抛出一个 OutOfMemory 异常。(线程启动过多)
- 参数 -Xss 去调整 JVM 栈的大小
了解 JVM 内存的方法有很多,具体能力范围也有区别,简单总结如下:
- 可以使用综合性的图形化工具,如 JConsole、VisualVM(注意,从 Oracle JDK 9 开始,VisualVM 已经不再包含在 JDK 安装包中)等。这些工具具体使用起来相对比较直观,直接连接到 Java 进程,然后就可以在图形化界面里掌握内存使用情况。
以 JConsole 为例,其内存页面可以显示常见的堆内存和各种堆外部分使用状态。
- 也可以使用命令行工具进行运行时查询,如 jstat 和 jmap 等工具都提供了一些选项,可以查看堆、方法区等使用数据。
- 或者,也可以使用 jmap 等提供的命令,生成堆转储(Heap Dump)文件,然后利用 jhat 或 Eclipse MAT 等堆转储分析工具进行详细分析。
- 如果你使用的是 Tomcat、Weblogic 等 Java EE 服务器,这些服务器同样提供了内存管理相关的功能。
- 另外,从某种程度上来说,GC 日志等输出,同样包含着丰富的信息。
这里有一个相对特殊的部分,就是堆外内存中的直接内存,前面的工具基本不适用,可以使用 JDK 自带的 Native Memory Tracking(NMT)特性,它会从 JVM 本地内存分配的角度进行解读。
在 Java 中,String 类型的特殊之处在于它可能会在两种位置存放:
- 字符串常量池(String Pool):
- 在 Java 中,所有的字符串常量(即直接通过双引号声明的字符串字面量)都会存放在字符串常量池中。字符串常量池是位于堆内存中的一块特殊的存储区域。
- 当程序中多次使用相同的字符串字面量时,Java虚拟机(JVM)会首先在字符串常量池中查找是否存在该字符串。如果存在,就复用已有的字符串引用,而不是重新创建一个新的字符串对象,这样可以节省内存空间。
- 堆内存(Heap):
- 通过
new关键字创建的字符串对象,或者通过字符串连接操作符(+)动态生成的字符串,会存放在Java堆内存中。 - 堆内存是Java中存放对象实例的地方,包括通过构造函数创建的
String对象。
- 通过
以下是两种情况的示例:
字符串常量池示例:
String str1 = "Hello, World!";
String str2 = "Hello, World!";

// str1和str2可能指向字符串常量池中的同一个对象堆内存示例:
String str1 = new String("Hello, World!");
String str2 = new String("Hello, World!");

// str1和str2指向堆内存中的不同对象,即使字符串内容相同注意:
- 在 Java 7 及以后的版本中,字符串常量池被移动到了堆内存中,而不是方法区。这是为了提高 JVM 的性能和减少内存碎片。
- 字符串常量池和堆内存中的字符串对象可能通过内部的
offset和count字段来共享char数组,这是通过Java的字符串共享机制实现的。 - 当使用
String.intern()方法时,可以将一个字符串对象放入字符串常量池中。如果字符串已经存在于池中的,intern()方法返回的是池中字符串的引用。
String str1 = new String("Hello, World!");
String str2 = str1.intern();

// str1和str2现在指向字符串常量池中的同一个对象简单来讲就是复制、克隆。
Person p=new Person(“张三”); 浅拷贝就是对对象中的数据成员进行简单赋值,如果存在动态成员或者指针就会报错。深拷贝就是对对象中存在的动态成员或指针重新开辟内存空间。
个人理解,程序运行时,内存中的信息大致分为两类:
跟程序执行逻辑相关的指令数据,这类数据通常不大,而且生命周期短;
跟对象实例相关的数据,这类数据可能会很大,而且可以被多个线程长时间内反复共用,比如字符串常量、缓存对象这类。
将这两类特点不同的数据分开管理,体现了软件设计上“模块隔离”的思想。好比我们通常会把后端 service 与前端 website 解耦类似,也更便于内存管理。
-
性能和效率:栈内存的分配和释放速度快,非常适合方法调用和局部变量的管理,而堆内存虽然管理复杂,但适合管理生命周期长、需要动态分配的对象。通过将内存分为栈和堆,JVM能够在不同场景下优化内存管理。
-
安全性:栈内存由每个线程独立拥有,保证了线程间的数据隔离,避免了数据竞争和安全问题。堆内存虽然是共享的,但通过同步机制可以确保线程安全。
-
灵活性:堆内存允许动态分配和释放,适应了Java语言中大量使用对象的特点,同时垃圾回收机制能够自动管理内存,减少了开发者手动管理内存的负担。
内存管理就是内存的生命周期管理,包括内存的申请、压缩、回收等操作。 Java 的内存管理就是 GC,JVM 的 GC 模块不仅管理内存的回收,也负责内存的分配和压缩整理。
Java 程序的指令都运行在 JVM 上,而且我们的程序代码并不需要去分配内存和释放内存(例如 C/C++ 里需要使用的 malloc/free),那么这些操作自然是由JVM帮我们搞定的。
JVM 在我们创建 Java 对象的时候去分配新内存,并使用 GC 算法,根据对象的存活时间,在对象不使用之后,自动执行对象的内存回收操作。
程序在运行的时候,为了提高性能,大部分数据都是会加载到内存中进行运算的,有些数据是需要常驻内存中的,但是有些数据,用过之后便不会再需要了,我们称这部分数据为垃圾数据。
为了防止内存被使用完,我们需要将这些垃圾数据进行回收,即需要将这部分内存空间进行释放。不同于 C++ 需要自行释放内存的机制,Java 虚拟机(JVM)提供了一种自动回收内存的机制,它是低优先级的,在正常情况下是不会执行的,只有在虚拟机空闲或者当前堆内存不足时,才会触发执行,扫面那些没有被任何引用的对象, 并将它们添加到要回收的集合中,进行回收。
自动垃圾收集的前提是清楚哪些内存可以被释放,内存中不再使用的空间就是垃圾
对于对象实例收集,主要是两种基本算法
-
引用计数法:引用计数算法,顾名思义,就是为对象添加一个引用计数,用于记录对象被引用的情况,如果计数为 0,即表示对象可回收。有循环引用问题
-
可达性分析:将对象及其引用关系看作一个图,选定活动的对象作为 GC Roots,然后跟踪引用链条,如果一个对象和 GC Roots 之间不可达,也就是不存在引用链条,那么即可认为是可回收对象


- 引用计数的增减开销在一些情况下会比较大,比如一些根引用的指针更新非常频繁,此时这种开销是不能忽视的(在每次赋值操作的时候都要做相当大的计算,尤其这里面还有递归调用)
- 对象引用计数器本身是需要空间的,而计数器要占用多少位也是一个问题
- 一个致命缺陷是循环引用,就是, objA引用了objB,objB也引用了objA,但是除此之外,再没有其他的地方引用这两个对象了,这两个对象的引用计数就都是1。这种情况下,这两个对象是不能被回收的。
为了解决引用计数法的循环引用问题,Java 使用了可达性分析的方法
可达性算法的原理是以一系列叫做 GC Root 的对象为起点出发,引出它们指向的下一个节点,再以下个节点为起点,引出此节点指向的下一个结点。。。(这样通过 GC Root 串成的一条线就叫引用链),直到所有的结点都遍历完毕,如果相关对象不在任意一个以 GC Root 为起点的引用链中,则这些对象会被判断为「垃圾」,会被 GC 回收。
哪些对象可以作为 GC Root 呢,有以下几类
- 虚拟机栈(栈帧中的本地变量表)中引用的对象
- 方法区中类静态属性引用的对象
- 方法区中常量引用的对象
- 本地方法栈中 JNI(即一般说的 Native 方法)引用的对象
- Java 虚拟机内部的引用,如基本数据类型对应的 Class 对象,一些常驻的异常对象
- 所有被同步锁(synchronized 关键字)持有的对象
- 反映 Java 虚拟机内部情况的 JMXBean、JVMTI 中注册的回调、本地代码缓存
在实际运行过程中,JVM 会通过维护一张全局的引用表来管理 GC Roots。这个表包含了所有活动线程、静态变量、常量引用和 JNI 全局引用等。垃圾回收器在进行标记阶段时,会遍历这个全局引用表,标记从 GC Roots 开始的所有可达对象。
thread 独享的区域:PC Regiester、JVM Stack、Native Method Stack,其生命周期都与线程相同(即与线程共生死),所以无需 GC。而线程共享的 Heap 区、Method Area 则是 GC 关注的重点对象
- 第一次标记
对象在进行可达性分析后发现没有与 GC Roots 相连接的引用链,那它将会被第一次标记。
-
第二次标记
假如对象没有覆盖 finalize 方法,或者 finalize 方法已经被虚拟机调用过,那么不执行 finalize 方法。 如果有必要执行 finalize 方法,那么该对象将会被放置在一个名为 F-Queue 的队列之中,并在稍后由一条由虚拟机自动建立的、低调度优先级的 Finalizer 线程去执行它们的 finalize 方法。
finalize 方法是对象逃脱死亡命运的最后一次机会,稍后收集器将对 F-Queue 中的对象进行第二次小规模的标记,如果对象要在 finalize 中成功拯救自己,只要重新与引用链上的任何一个对象建立关联即可。 如果对象这时候还没有逃脱,那基本上它就真的要被回收了。
垃圾回收(Garbage Collection, GC)是自动内存管理的关键部分,用于回收不再使用的对象,防止内存泄漏。以下是一些常用的GC算法及其优缺点:
| 算法 | 思路 | 优点 | 缺点 |
|---|---|---|---|
| 标记-清除(Mark-Sweep) |  黑色区域表示待清理的垃圾对象,标记出来后直接清空 |
简单易懂。 不需要移动对象,保留了对象的原始引用。 |
效率问题:标记和清除过程可能产生较长的停顿时间(Stop-the-World)。 内存碎片:清除后内存中可能会有大量碎片,影响后续内存分配 |
| 标记-整理(Mark-Compact) |  将垃圾对象清理掉后,同时将剩下的存活对象进行整理挪动(类似于 windows 的磁盘碎片整理),保证它们占用的空间连续 |
解决了内存碎片问题,通过整理阶段移动对象,减少内存碎片。 | 效率问题:整理阶段可能需要移动对象,增加GC的开销。 移动对象可能导致额外的开销,因为需要更新所有指向移动对象的引用。 |
| 复制(Copying) |  将内存对半分,总是保留一块空着(上图中的右侧),将左侧存活的对象(浅灰色区域)复制到右侧,然后左侧全部清空 |
简单且高效,特别适合新生代GC。 没有内存碎片问题,因为复制算法通过复制存活对象到另一个空间来避免碎片。 | 空间利用率低:只使用堆的一半(或者根据算法不同,使用的比例不同)。 复制过程可能产生短暂的停顿。 |
| 分代收集(Generational Collection) |  |
基于弱分代假设(大部分对象都是朝生夕死的),通过将对象分配到不同的代来优化GC性能。 新生代使用复制算法,老年代使用标记-清除或标记-整理算法。 | 对于长寿命的对象,如果频繁晋升到老年代,可能会增加老年代的GC压力。 需要维护多个数据结构来区分不同代的对象。 |
每种GC算法都有其适用场景和限制。选择合适的GC算法取决于应用程序的具体需求,包括对延迟的敏感度、堆内存的大小、对象的生命周期特性等因素。现代JVM通常提供了多种GC算法,允许开发者根据需要选择或调整。
思路: 先描述一下Java堆内存划分,再解释Minor GC,Major GC,full GC,描述它们之间转化流程。
-
Java堆 = 老年代 + 新生代
-
新生代 = Eden + S0 + S1
-
当 Eden 区的空间满了, Java虚拟机会触发一次 Minor GC,以收集新生代的垃圾,存活下来的对象,则会转移到 Survivor区。
-
大对象(需要大量连续内存空间的Java对象,如那种很长的字符串)直接进入老年态;
-
如果对象在 Eden 出生,并经过第一次 Minor GC 后仍然存活,并且被 Survivor 容纳的话,年龄设为 1,每熬过一次 Minor GC,年龄+1,若年龄超过一定限制(15),则被晋升到老年态。即长期存活的对象进入老年态。
s0 与 s1 的角色其实会互换,来回移动
注:这里其实已经综合运用了“【标记-清理eden】+【标记-复制 eden->s0】”算法。
-
老年代满了而无法容纳更多的对象,Minor GC 之后通常就会进行Full GC,Full GC 清理整个内存堆 – 包括年轻代和年老代。
-
Major GC 发生在老年代的GC,清理老年区,经常会伴随至少一次Minor GC,比Minor GC慢10倍以上。
在 hotspot 虚拟机中,对象在堆内存中的存储布局可以划分为三部分:对象头,实例数据,对齐填充。 HotSpot虚拟机对象的对象头部包含两类信息
- 用于存储对象自身的运行时数据,如HashCode,GC的分代年龄,锁状态标志,线程持有的锁,偏向线程ID,偏向时间戳等。这部数据的长度在32位和64位的虚拟机中分别为32比特和64比特,官方称为“Mark word”。
- 另一种是类型指针,即对象指向它的类型元数据的指针,Java通过这个指针确定该对象是哪个类的实例。但是并不是所有的虚拟机实现都必须在对象数据上保留类型指针,换句话说,查找对象的元数据信息不一定要经过对象本身。
在32位的HotSpot虚拟机中,如对象未被同步锁锁定的状态下,Mark Word的32个比特存储空间中的25个比特用于存储对象的HashCode,4个比特存储对象分代年龄,2个比特存储锁标志位,一个比特固定为0.
因为Object Header采用4个bit位来保存年龄,4个bit位能表示的最大数就是15!
在 JVM 的实现中,尤其是 HotSpot 虚拟机中,分代年龄的最大值是 15。这是由 JVM 的设计和垃圾收集器的实现所决定的,主要原因如下:
标记字段的位数限制:
- 在 HotSpot VM 中,对象头的 Mark Word 里存储了对象的年龄信息。对象头的 Mark Word 是一个 32 位或者 64 位的字段 (取决于 JVM 的运行模式)。
- 为了高效地存储和管理对象的年龄,JVM 为年龄字段分配了 4 位。这意味着对象年龄的范围是 0 到 15,即最大为 15。
合理的晋升策略:
- 在分代垃圾收集策略中,大多数对象在年轻代创建,并且很快变得不可达而被回收。少数存活较长的对象会逐渐晋升到老年代。
- 通过设定最大年龄为 15,可以确保在适当的时间点将长期存活的对象晋升到老年代,减少年轻代的负担。
- 这一设计是基于常见的对象生命周期分布 (即大部分对象短命,少数对象长寿) 而进行的优化。
性能和效率:
- 使用 4 位来表示对象年龄,使得垃圾收集器能够高效地处理和管理对象的晋升逻辑。
- 限制年龄最大为 15 简化了垃圾收集器的实现,并且足以区分短命对象和长命对象,从而优化垃圾收集的性能。
GC 垃圾回收算法和垃圾收集器的关系?分别是什么请你谈谈?
实际上,垃圾收集器(GC,Garbage Collector)是和具体 JVM 实现紧密相关的,不同厂商(IBM、Oracle),不同版本的 JVM,提供的选择也不同。
不算上后面出现的神器 ZGC,历史上出现过 7 种经典的垃圾回收器。
这些回收器都是基于分代的,把 G1 除外,按回收的分代划分如下。
横线以上的 3 种:Serial、ParNew、Parellel Scavenge 都是回收年青代的;
横线以下的 3 种:CMS、Serial Old、Parallel Old 都是回收老年代的。

思路: 一定要记住典型的垃圾收集器,尤其 cms 和 G1,它们的原理与区别,涉及的垃圾回收算法。
-
Serial收集器: 单线程的收集器,收集垃圾时,必须 stop the world,使用复制算法。无需维护复杂的数据结构,初始化也简单,所以一直是 Client 模式下 JVM 的默认选项
-
ParNew收集器: 一款多线程的收集器,采用复制算法,主要工作在 Young 区,可以通过
-XX:ParallelGCThreads参数来控制收集的线程数,整个过程都是 STW 的,常与 CMS 组合使用 -
Parallel Scavenge收集器: 新生代收集器,复制算法的收集器,并发的多线程收集器,目标是达到一个可控的吞吐量。如果虚拟机总共运行100分钟,其中垃圾花掉1分钟,吞吐量就是99%。
-
Serial Old收集器: 是Serial收集器的老年代版本,单线程收集器,使用标记整理算法。
-
Parallel Old收集器: 是Parallel Scavenge收集器的老年代版本,使用多线程,标记-整理算法。
-
CMS(Concurrent Mark Sweep) 收集器: 是一种以获得最短回收停顿时间为目标的收集器,标记清除算法,运作过程:初始标记,并发标记,重新标记,并发清除,收集结束会产生大量空间碎片。其中初始标记和重新标记会 STW。另外,既然强调了并发(Concurrent),CMS 会占用更多 CPU 资源,并和用户线程争抢。多数应用于互联网站或者 B/S 系统的服务器端上,JDK9 被标记弃用,JDK14 被删除,详情可见 JEP 363。
-
G1收集器: 一种兼顾吞吐量和停顿时间的 GC 实现,是 Oracle JDK 9 以后的默认 GC 选项。
G1 GC 仍然存在着年代的概念,但是其内存结构并不是简单的条带式划分,而是类似棋盘的一个个 region。Region 之间是复制算法,但整体上实际可看作是标记 - 整理(Mark-Compact)算法,可以有效地避免内存碎片,尤其是当 Java 堆非常大的时候,G1 的优势更加明显。
标记整理算法实现,运作流程主要包括以下:初始标记,并发标记,最终标记,筛选标记。不会产生空间碎片,可以精确地控制停顿。

目前使用最多的是 CMS 和 G1 收集器,二者都有分代的概念,主要内存结构如下

- CMS 收集器是老年代的收集器,可以配合新生代的 Serial 和 ParNew 收集器一起使用;
- G1 收集器收集范围是老年代和新生代,不需要结合其他收集器使用;
- CMS 收集器以最小的停顿时间为目标的收集器;
- G1 GC 这是一种兼顾吞吐量和停顿时间的 GC 实现,是 Oracle JDK 9 以后的默认 GC 选项。
- G1 GC 仍然存在着年代的概念,但是其内存结构并不是简单的条带式划分,而是类似棋盘的一个个 region。Region 之间是复制算法,但整体上实际可看作是标记 - 整理(Mark-Compact)算法,可以有效地避免内存碎片,尤其是当 Java 堆非常大的时候,G1 的优势更加明显。G1 吞吐量和停顿表现都非常不错,并且仍然在不断地完善,与此同时 CMS 已经在 JDK 9 中被标记为废弃(deprecated),所以 G1 GC 值得你深入掌握。
- CMS 收集器是使用“标记-清除”算法进行的垃圾回收,容易产生内存碎片
如果你有关注目前尚处于开发中的 JDK 11,你会发现,JDK 又增加了两种全新的 GC 方式,分别是:
- Epsilon GC,简单说就是个不做垃圾收集的 GC,似乎有点奇怪,有的情况下,例如在进行性能测试的时候,可能需要明确判断 GC 本身产生了多大的开销,这就是其典型应用场景。
- ZGC,这是 Oracle 开源出来的一个超级 GC 实现,具备令人惊讶的扩展能力,比如支持 T bytes 级别的堆大小,并且保证绝大部分情况下,延迟都不会超过 10 ms。虽然目前还处于实验阶段,仅支持 Linux 64 位的平台,但其已经表现出的能力和潜力都非常令人期待。
收集年轻代内存的 GC 事件称为 Minor GC。关于 Minor GC 事件,我们需要了解一些相关的内容:
-
当 JVM 无法为新对象分配内存空间时就会触发 Minor GC( 一般就是 Eden 区用满了)。如果对象的分配速率很快,那么 Minor GC 的次数也就会很多,频率也就会很快。
-
Minor GC 事件不处理老年代,所以会把所有从老年代指向年轻代的引用都当做 GC Root。从年轻代指向老年代的引用则在标记阶段被忽略。
-
与我们一般的认知相反,Minor GC 每次都会引起 STW 停顿(stop-the-world),挂起所有的应用线程。对大部分应用程序来说,Minor GC 的暂停时间可以忽略不计,因为 Eden 区里面的对象大部分都是垃圾,也不怎么复制到存活区/老年代。但如果不符合这种情况,那么很多新创建的对象就不能被 GC 清理,Minor GC 的停顿时间就会增大,就会产生比较明显的 GC 性能影响。
我们知道,除了 Minor GC 外,另外两种 GC 事件则是:
- Major GC(大型 GC):清理老年代空间(Old Space)的 GC 事件。
- Full GC(完全 GC):清理整个堆内存空间的 GC 事件,包括年轻代空间和老年代空间。
-
System.gc()方法的调用此方法的调用是建议 JVM 进行 Full GC,虽然只是建议而非一定,但很多情况下它会触发 Full GC,从而增加Full GC 的频率,也即增加了间歇性停顿的次数。强烈影响系建议能不使用此方法就别使用,让虚拟机自己去管理它的内存,可通过通过 -XX:+ DisableExplicitGC 来禁止 RMI 调用 System.gc。
-
老年代空间不足
老年代空间只有在新生代对象转入及创建大对象、大数组时才会出现不足的现象,当执行 Full GC 后空间仍然不足,则抛出如下错误:java.lang.OutOfMemoryError: Java heap space 为避免以上两种状况引起的 Full GC,调优时应尽量做到让对象在 Minor GC 阶段被回收、让对象在新生代多存活一段时间及不要创建过大的对象及数组。
-
老年代的内存使用率达到了一定阈值(可通过参数调整),直接触发 FGC
-
空间分配担保:在 YGC 之前,会先检查老年代最大可用的连续空间是否大于新生代所有对象的总空间。如果小于,说明 YGC 是不安全的,则会查看参数 HandlePromotionFailure 是否被设置成了允许担保失败,如果不允许则直接触发 Full GC;如果允许,那么会进一步检查老年代最大可用的连续空间是否大于历次晋升到老年代对象的平均大小,如果小于也会触发 Full GC
-
Metaspace(元空间)在空间不足时会进行扩容,当扩容到了-XX:MetaspaceSize 参数的指定值时,也会触发FGC
java.lang.System.gc() 只是 java.lang.Runtime.getRuntime().gc() 的简写,两者的行为没有任何不同
其实基本没什么机会用得到这个命令,因为这个命令只是建议 JVM 安排 GC 运行,还有可能完全被拒绝。 GC 本身是会周期性的自动运行的,由 JVM 决定运行的时机,而且现在的版本有多种更智能的模式可以选择,还会根据运行的机器自动去做选择,就算真的有性能上的需求,也应该去对 GC 的运行机制进行微调,而不是通过使用这个命令来实现性能的优化
比如 GC 的时候必须要等到 Java 线程都进入到 safepoint 的时候 VMThread 才能开始 执行 GC,
- 循环的末尾 (防止大循环的时候一直不进入 safepoint,而其他线程在等待它进入 safepoint)
- 方法返回前
- 调用方法的call之后
- 抛出异常的位置
APP_OPTS:-Xms6656m -Xmx6656m -XX:MetaspaceSize=512m -XX:MaxMetaspaceSize=1024m -XX:+UseG1GC -XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/home/finance/Logs/vspreadboss.msxf.lo/vspreadbossHeap.hprof
-verbose:gc -Xloggc:/home/finance/Logs/vspreadboss.msxf.lo/gc.log
-XX:+PrintGC -XX:+PrintGCDateStamps -XX:+PrintGCDetails -XX:+PrintHeapAtGC
-Dprofiler.msxf.thread.pool.enable=true  -Dprofiler.msxf.thread.pool.spring.enable=true
-Dprofiler.msxf.thread.pool.reject-handler.enable=true -Dprofiler.jdbc.druid.poolmetric=true
xxx 143 1 54 Jun07 ? 1-13:05:06 /opt/local/jdk/bin/java -Djava.util.logging.config.file=/opt/local/tomcat/conf/logging.properties -Djava.util.logging.manager=org.apache.juli.ClassLoaderLogManager -server -Xmn1024m -Xms22938M -Xmx22938M -XX:PermSize=512m -XX:MaxPermSize=512m -XX:ParallelGCThreads=3 -XX:+UseConcMarkSweepGC -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=80 -XX:+CMSScavengeBeforeRemark -XX:SoftRefLRUPolicyMSPerMB=0 -XX:ParallelGCThreads=3 -Xss1m -XX:+PrintGCDateStamps -XX:+PrintGCDetails -Xloggc:/opt/logs/gc.log -verbose:gc -XX:+DisableExplicitGC -Dsun.rmi.transport.tcp.maxConnectionThreads=400 -XX:+ParallelRefProcEnabled -XX:+PrintTenuringDistribution -Dsun.rmi.transport.tcp.handshakeTimeout=2000 -Xdebug -Xrunjdwp:transport=dt_socket,address=22062,server=y,suspend=n -Dcom.sun.management.snmp.port=18328 -Dcom.sun.management.snmp.interface=0.0.0.0 -Dcom.sun.management.snmp.acl=false -javaagent:/opt/opbin/service_control/script/jmx_prometheus_javaagent-0.13.0.jar=9999:/opt/opbin/service_control/script/config.yaml -Djdk.tls.ephemeralDHKeySize=2048 -Djava.protocol.handler.pkgs=org.apache.catalina.webresources -Dignore.endorsed.dirs= -classpath /opt/local/tomcat/bin/bootstrap.jar:/opt/local/tomcat/bin/tomcat-juli.jar -Dcatalina.base=/opt/local/tomcat -Dcatalina.home=/opt/local/tomcat -Djava.io.tmpdir=/opt/local/tomcat/temp org.apache.catalina.startup.Bootstrap start start
G1(Garbage First)垃圾收集器是Java虚拟机的一种先进的垃圾收集器,设计目的是在大内存和多处理器环境中提供低停顿时间和高吞吐量的垃圾收集性能。它在JDK 7u4中引入,并在JDK 9中成为推荐的垃圾收集器,用于替代CMS(Concurrent Mark-Sweep)收集器。
G1垃圾收集器的主要特点:
- 分区内存:G1将堆划分为多个相等大小的独立区域(Regions),每个区域可以作为Eden、Survivor或老年代空间。这样可以更灵活地管理内存,减少内存碎片。
- 并行和并发:G1利用多核处理器的优势,进行并行和并发的垃圾收集操作,减少应用程序的停顿时间。
- 预测性暂停时间:G1允许用户设定期望的最大暂停时间目标,并通过合理安排垃圾收集任务来尽量满足这个目标。
- 混合收集:G1在老年代内存占用超过一定比例后,会同时收集年轻代和部分老年代内存,称为混合收集(Mixed Collection)。
- 全堆压缩:G1在垃圾收集时,会将存活对象移动到较少的区域中,释放出连续的空闲内存区域,减少内存碎片,提高内存利用率。
首先,先来整体了解一下 G1 GC 的内部结构和主要机制。
从内存区域的角度,G1 同样存在着年代的概念,但是与我前面介绍的内存结构很不一样,其内部是类似棋盘状的一个个 region 组成
region 的大小是一致的,数值是在 1M 到 32M 字节之间的一个 2 的幂值数,JVM 会尽量划分 2048 个左右、同等大小的 region。当然这个数字既可以手动调整,G1 也会根据堆大小自动进行调整。
在 G1 实现中,年代是个逻辑概念,具体体现在,一部分 region 是作为 Eden,一部分作为 Survivor,除了意料之中的 Old region,G1 会将超过 region 50% 大小的对象(在应用中,通常是 byte 或 char 数组)归类为 Humongous 对象,并放置在相应的 region 中。逻辑上,Humongous region 算是老年代的一部分,因为复制这样的大对象是很昂贵的操作,并不适合新生代 GC 的复制算法。
你可以思考下 region 设计有什么副作用?
例如,region 大小和大对象很难保证一致,这会导致空间的浪费。不知道你有没有注意到,我的示意图中有的区域是 Humongous 颜色,但没有用名称标记,这是为了表示,特别大的对象是可能占用超过一个 region 的。并且,region 太小不合适,会令你在分配大对象时更难找到连续空间,这是一个长久存在的情况,请参考OpenJDK 社区的讨论。这本质也可以看作是 JVM 的 bug,尽管解决办法也非常简单,直接设置较大的 region 大小,参数如下:
-XX:G1HeapRegionSize=<N, 例如 16>M
从 GC 算法的角度,G1 选择的是复合算法,可以简化理解为:
- 在新生代,G1 采用的仍然是并行的复制算法,所以同样会发生 Stop-The-World 的暂停。
- 在老年代,大部分情况下都是并发标记,而整理(Compact)则是和新生代 GC 时捎带进行,并且不是整体性的整理,而是增量进行的。
习惯上人们喜欢把新生代 GC(Young GC)叫作 Minor GC,老年代 GC 叫作 Major GC,区别于整体性的 Full GC。但是现代 GC 中,这种概念已经不再准确,对于 G1 来说:
- Minor GC 仍然存在,虽然具体过程会有区别,会涉及 Remembered Set 等相关处理。
- 老年代回收,则是依靠 Mixed GC。并发标记结束后,JVM 就有足够的信息进行垃圾收集,Mixed GC 不仅同时会清理 Eden、Survivor 区域,而且还会清理部分 Old 区域。可以通过设置下面的参数,指定触发阈值,并且设定最多被包含在一次 Mixed GC 中的 region 比例。
–XX:G1MixedGCLiveThresholdPercent
–XX:G1OldCSetRegionThresholdPercent
从 G1 内部运行的角度,下面的示意图描述了 G1 正常运行时的状态流转变化,当然,在发生逃逸失败等情况下,就会触发 Full GC。
G1 相关概念非常多,有一个重点就是 Remembered Set,用于记录和维护 region 之间对象的引用关系。为什么需要这么做呢?试想,新生代 GC 是复制算法,也就是说,类似对象从 Eden 或者 Survivor 到 to 区域的“移动”,其实是“复制”,本质上是一个新的对象。在这个过程中,需要必须保证老年代到新生代的跨区引用仍然有效。下面的示意图说明了相关设计。
主要用于解决分代垃圾收集器中的跨代引用问题
G1 的很多开销都是源自 Remembered Set,例如,它通常约占用 Heap 大小的 20% 或更高,这可是非常可观的比例。并且,我们进行对象复制的时候,因为需要扫描和更改 Card Table 的信息,这个速度影响了复制的速度,进而影响暂停时间。
接下来,我介绍下大家可能还不了解的 G1 行为变化,它们在一定程度上解决了专栏其他讲中提到的部分困扰,如类型卸载不及时的问题。
- 上面提到了 Humongous 对象的分配和回收,这是很多内存问题的来源,Humongous region 作为老年代的一部分,通常认为它会在并发标记结束后才进行回收,但是在新版 G1 中,Humongous 对象回收采取了更加激进的策略。 我们知道 G1 记录了老年代 region 间对象引用,Humongous 对象数量有限,所以能够快速的知道是否有老年代对象引用它。如果没有,能够阻止它被回收的唯一可能,就是新生代是否有对象引用了它,但这个信息是可以在 Young GC 时就知道的,所以完全可以在 Young GC 中就进行 Humongous 对象的回收,不用像其他老年代对象那样,等待并发标记结束。
- 在垃圾收集过程中,G1 会把新创建的字符串对象放入队列中,然后在 Young GC 之后,并发地(不会 STW)将内部数据(char 数组,JDK 9 以后是 byte 数组)一致的字符串进行排重,也就是将其引用同一个数组。你可以使用下面参数激活:
-XX:+UseStringDeduplication
注意,这种排重虽然可以节省不少内存空间,但这种并发操作会占用一些 CPU 资源,也会导致 Young GC 稍微变慢。
- 类型卸载是个长期困扰一些 Java 应用的问题,一个类只有当加载它的自定义类加载器被回收后,才能被卸载。元数据区替换了永久代之后有所改善,但还是可能出现问题。
G1 的类型卸载有什么改进吗?很多资料中都谈到,G1 只有在发生 Full GC 时才进行类型卸载,但这显然不是我们想要的。你可以加上下面的参数查看类型卸载:
-XX:+TraceClassUnloading
幸好现代的 G1 已经不是如此了,8u40 以后,G1 增加并默认开启下面的选项:
-XX:+ClassUnloadingWithConcurrentMark
也就是说,在并发标记阶段结束后,JVM 即进行类型卸载。
- 我们知道老年代对象回收,基本要等待并发标记结束。这意味着,如果并发标记结束不及时,导致堆已满,但老年代空间还没完成回收,就会触发 Full GC,所以触发并发标记的时机很重要。早期的 G1 调优中,通常会设置下面参数,但是很难给出一个普适的数值,往往要根据实际运行结果调整
-XX:InitiatingHeapOccupancyPercent
在 JDK 9 之后的 G1 实现中,这种调整需求会少很多,因为 JVM 只会将该参数作为初始值,会在运行时进行采样,获取统计数据,然后据此动态调整并发标记启动时机。对应的 JVM 参数如下,默认已经开启:
-XX:+G1UseAdaptiveIHOP
- 在现有的资料中,大多指出 G1 的 Full GC 是最差劲的单线程串行 GC。其实,如果采用的是最新的 JDK,你会发现 Full GC 也是并行进行的了,在通用场景中的表现还优于 Parallel GC 的 Full GC 实现。
当然,还有很多其他的改变,比如更快的 Card Table 扫描等,这里不再展开介绍,因为它们并不带来行为的变化,基本不影响调优选择。
前面介绍了 G1 的内部机制,并且穿插了部分调优建议,下面从整体上给出一些调优的建议。
首先,建议尽量升级到较新的 JDK 版本,从上面介绍的改进就可以看到,很多人们常常讨论的问题,其实升级 JDK 就可以解决了。
第二,掌握 GC 调优信息收集途径。掌握尽量全面、详细、准确的信息,是各种调优的基础,不仅仅是 GC 调优。我们来看看打开 GC 日志,这似乎是很简单的事情,可是你确定真的掌握了吗?
除了常用的两个选项,
-XX:+PrintGCDetails
-XX:+PrintGCDateStamps
还有一些非常有用的日志选项,很多特定问题的诊断都是要依赖这些选项:
-XX:+PrintAdaptiveSizePolicy // 打印 G1 Ergonomics 相关信息
我们知道 GC 内部一些行为是适应性的触发的,利用 PrintAdaptiveSizePolicy,我们就可以知道为什么 JVM 做出了一些可能我们不希望发生的动作。例如,G1 调优的一个基本建议就是避免进行大量的 Humongous 对象分配,如果 Ergonomics 信息说明发生了这一点,那么就可以考虑要么增大堆的大小,要么直接将 region 大小提高。
如果是怀疑出现引用清理不及时的情况,则可以打开下面选项,掌握到底是哪里出现了堆积。
-XX:+PrintReferenceGC
另外,建议开启选项下面的选项进行并行引用处理。
-XX:+ParallelRefProcEnabled
需要注意的一点是,JDK 9 中 JVM 和 GC 日志机构进行了重构,其实我前面提到的PrintGCDetails 已经被标记为废弃,而PrintGCDateStamps 已经被移除,指定它会导致 JVM 无法启动。可以使用下面的命令查询新的配置参数。
java -Xlog:help
最后,来看一些通用实践,理解了我前面介绍的内部结构和机制,很多结论就一目了然了,例如:
- 如果发现 Young GC 非常耗时,这很可能就是因为新生代太大了,我们可以考虑减小新生代的最小比例。
-XX:G1NewSizePercent
降低其最大值同样对降低 Young GC 延迟有帮助。
-XX:G1MaxNewSizePercent
如果我们直接为 G1 设置较小的延迟目标值,也会起到减小新生代的效果,虽然会影响吞吐量。
- 如果是 Mixed GC 延迟较长,我们应该怎么做呢?
还记得前面说的,部分 Old region 会被包含进 Mixed GC,减少一次处理的 region 个数,就是个直接的选择之一。 我在上面已经介绍了 G1OldCSetRegionThresholdPercent 控制其最大值,还可以利用下面参数提高 Mixed GC 的个数,当前默认值是 8,Mixed GC 数量增多,意味着每次被包含的 region 减少。
-XX:G1MixedGCCountTarget
ZGC 即 Z Garbage Collector(Z 垃圾收集器,Z 有 Zero 的意思,主要作者是 Oracle 的 Per Liden),这是一款低停顿、高并发,基于小堆块(region)、不分代的增量压缩式垃圾收集器,平均 GC 耗时不到 2 毫秒,最坏情况下的暂停时间也不超过 10 毫秒。
像 G1 和 ZGC 之类的现代 GC 算法,只要空闲的堆内存足够多,基本上不触发 FullGC。
所以很多时候,只要条件允许,加内存才是最有效的解决办法。
既然低延迟是 ZGC 的核心看点,而 JVM 低延迟的关键是 GC 暂停时间,那么我们来看看有哪些方法可以减少 GC 暂停时间:
- 使用多线程“并行”清理堆内存,充分利用多核 CPU 的资源;
- 使用“分阶段”的方式运行 GC 任务,把暂停时间打散;
- 使用“增量”方式进行处理,每次 GC 只处理一部分堆内存(小堆块,region);
- 让 GC 与业务线程“并发”执行,例如增加并发标记,并发清除等阶段,从而把暂停时间控制在非常短的范围内(目前来说还是必须使用少量的 STW 暂停,比如根对象的扫描,最终标记等阶段);
- 完全不进行堆内存整理,比如 Golang 的 GC 就采用这种方式(题外话)。
在 G1 的基础上,它做了如下 7 点改进(JDK 11 开始引入)
-
动态调整大小的 Region
-
不分代,干掉了 RSets
G1 中每个 Region 需要借助额外的 RSets 来记录“谁引用了我”,占用了额外的内存空间,每次对象移动时,RSets 也需要更新,会产生开销。
-
带颜色的指针 Colored Pointer
这里的指针类似 Java 中的引用,意为对某块虚拟内存的引用。ZGC 采用了64位指针(注:目前只支持 linux 64 位系统),将 42-45 这 4 个 bit 位置赋予了不同含义,即所谓的颜色标志位,也换为指针的 metadata。
-
finalizable 位:仅 finalizer(类比 C++ 中的析构函数)可访问;
-
remap 位:指向对象当前(最新)的内存地址,参考下面提到的relocation;
-
marked0 && marked1 位:用于标志可达对象。
这 4 个标志位,同一时刻只会有 1 个位置是 1。每当指针对应的内存数据发生变化,比如内存被移动,颜色会发生变化。
-
-
读屏障 Load Barrier
传统 GC 做标记时,为了防止其他线程在标记期间修改对象,通常会简单的 STW。而 ZGC 有了 Colored Pointer 后,引入了所谓的“读屏障”。
当指针引用的内存正被移动时,指针上的颜色就会变化,ZGC 会先把指针更新成最新状态,然后再返回(你可以回想下 Java 中的 volatile 关键字,有异曲同工之妙)。这样仅读取该指针时,可能会略有开销,而不用将整个 heap STW。
-
重定位 Relocation
如下图,在标记过程中,先从 Roots 对象找到了直接关联的下级对象 1,2,4。
然后继续向下层标记,找到了 5,8 对象, 此时已经可以判定 3,6,7 为垃圾对象。
如果按常规思路,一般会将 8 从最右侧的 Region,移动或复制到中间的 Region,然后再将中间 Region 的 3 干掉,最后再对中间 Region 做压缩 compact 整理。
但 ZGC 做得更高明,它直接将 4,5 复制到了一个空的新 Region 就完事了,然后中间的 2 个 Region 直接废弃,或理解为“释放”,作为下次回收的“新” Region。这样的好处是避免了中间 Region 的 compact 整理过程。
最后,指针重新调整为正确的指向(即:remap),而且上一阶段的 remap 与下一阶段的mark是混在一起处理的,相对更高效。
【 Remap 的流程图】
-
多重映射 Multi-Mapping
-
支持 NUMA 架构


思路: 可以说一下堆栈配置相关的,垃圾收集器相关的,还有一下辅助信息相关的。
java -Xmx3550m -Xms3550m -Xmn2g -Xss128k
-XX:MaxPermSize=16m -XX:NewRatio=4 -XX:SurvivorRatio=4 -XX:MaxTenuringThreshold=0
-Xmx3550m: 最大堆大小为3550m。
-Xms3550m: 设置初始堆大小为3550m。
-Xmn2g: 设置年轻代大小为2g。
-Xss128k: 每个线程的堆栈大小为128k。
-XX:MaxPermSize: 设置持久代大小为16m
-XX:NewRatio=4: 设置年轻代(包括Eden和两个Survivor区)与年老代的比值(除去持久代)。
-XX:SurvivorRatio=4: 设置年轻代中Eden区与Survivor区的大小比值。设置为4,则两个Survivor区与一个Eden区的比值为2:4,一个Survivor区占整个年轻代的1/6
-XX:MaxTenuringThreshold=0: 设置垃圾最大年龄。如果设置为0的话,则年轻代对象不经过Survivor区,直接进入年老代。
-XX:+UseParallelGC
-XX:ParallelGCThreads=20
-XX:+UseConcMarkSweepGC
-XX:CMSFullGCsBeforeCompaction=5
-XX:+UseCMSCompactAtFullCollection:
-XX:+UseParallelGC: 选择垃圾收集器为并行收集器。
-XX:ParallelGCThreads=20: 配置并行收集器的线程数
-XX:+UseConcMarkSweepGC: 设置年老代为并发收集。
-XX:CMSFullGCsBeforeCompaction:由于并发收集器不对内存空间进行压缩、整理,所以运行一段时间以后会产生“碎片”,使得运行效率降低。此值设置运行多少次GC以后对内存空间进行压缩、整理。
-XX:+UseCMSCompactAtFullCollection: 打开对年老代的压缩。可能会影响性能,但是可以消除碎片
-XX:+PrintGC
-XX:+PrintGCDetails
-XX:+PrintGC 输出形式:
[GC 118250K->113543K(130112K), 0.0094143 secs] [Full GC 121376K->10414K(130112K), 0.0650971 secs]
-XX:+PrintGCDetails 输出形式:
[GC [DefNew: 8614K->781K(9088K), 0.0123035 secs] 118250K->113543K(130112K), 0.0124633 secs] [GC [DefNew: 8614K->8614K(9088K), 0.0000665 secs][Tenured: 112761K->10414K(121024K), 0.0433488 secs] 121376K->10414K(130112K), 0.0436268 secs
# 设置堆内存
-Xmx4g -Xms4g
# 指定 GC 算法
-XX:+UseG1GC -XX:MaxGCPauseMillis=50
# 指定 GC 并行线程数
-XX:ParallelGCThreads=4
# 打印 GC 日志
-XX:+PrintGCDetails -XX:+PrintGCDateStamps
# 指定 GC 日志文件
-Xloggc:gc.log
# 指定 Meta 区的最大值
-XX:MaxMetaspaceSize=2g
# 设置单个线程栈的大小
-Xss1m
# 指定堆内存溢出时自动进行 Dump
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/usr/local/
-
标配参数
- -version (java -version)
- -help (java -help)
- java -showversion
-
X 参数(了解)
-
-Xint 解释执行
-
-Xcomp 第一次使用就编译成本地代码
-
-Xmixed 混合模式
-
-
xx参数
-
Boolean 类型
-
公式: -xx:+ 或者 - 某个属性值(+表示开启,- 表示关闭)
-
Case
-
是否打印GC收集细节
- -XX:+PrintGCDetails
- -XX:- PrintGCDetails
添加如下参数后,重新查看,发现是 + 号了
-
是否使用串行垃圾回收器
- -XX:-UseSerialGC
-
-
-XX:+UseSerialGC
-
-
KV 设值类型
-
公式 -XX:属性key=属性 value
-
Case:
-
-XX:MetaspaceSize=128m
-
-xx:MaxTenuringThreshold=15
-
我们常见的 -Xms和 -Xmx 也属于 KV 设值类型
- -Xms 等价于 -XX:InitialHeapSize
- -Xmx 等价于 -XX:MaxHeapSize
-
-
-
jinfo 举例,如何查看当前运行程序的配置
- jps -l
- jinfo -flag [配置项] 进程编号
- jinfo -flags 1981(打印所有)
- jinfo -flag PrintGCDetails 1981
- jinfo -flag MetaspaceSize 2044
-
这些都是命令级别的查看,我们如何在程序运行中查看
long totalMemory = Runtime.getRuntime().totalMemory();
long maxMemory = Runtime.getRuntime().maxMemory();

System.out.println("total_memory(-xms)="+totalMemory+"字节," +(totalMemory/(double)1024/1024)+"MB");
System.out.println("max_memory(-xmx)="+maxMemory+"字节," +(maxMemory/(double)1024/1024)+"MB");-
-XX:+PrintFlagsInitial
-
主要查看初始默认值
-
java -XX:+PrintFlagsInitial
-
java -XX:+PrintFlagsInitial -version
等号前有冒号 := 说明 jvm 参数有人为修改过或者 JVM加载修改
false 说明是Boolean 类型 参数,数字说明是 KV 类型参数
-
-
-XX:+PrintFlagsFinal
- 主要查看修改更新
- java -XX:+PrintFlagsFinal
- java -XX:+PrintFlagsFinal -version
- 运行java命令的同时打印出参数 java -XX:+PrintFlagsFinal -XX:MetaspaceSize=512m Hello.java
-
-XX:+PrintCommondLineFlags
- 打印命令行参数
- java -XX:+PrintCommondLineFlags -version
- 可以方便的看到垃圾回收器
-
java.lang.StackOverflowError
public class StackOverflowErrorDemo {

  public static void main(String[] args) {
      stackoverflowError();
  }

  private static void stackoverflowError() {
      stackoverflowError();
  }
}
-
java.lang.OutOfMemoryError: Java heap space
- new个大对象,就会出现
//JVM参数:-Xmx12m
static final int SIZE = 2 * 1024 * 1024;

public static void main(String[] a) {
    int[] i = new int[SIZE];
}
谈到调优,这一定是针对特定场景、特定目的的事情, 对于 GC 调优来说,首先就需要清楚调优的目标是什么?从性能的角度看,通常关注三个方面,内存占用(footprint)、延时(latency)和吞吐量(throughput),大多数情况下调优会侧重于其中一个或者两个方面的目标,很少有情况可以兼顾三个不同的角度。当然,除了上面通常的三个方面,也可能需要考虑其他 GC 相关的场景,例如,OOM 也可能与不合理的 GC 相关参数有关;或者,应用启动速度方面的需求,GC 也会是个考虑的方面。
- 延迟(Latency): 也可以理解为最大停顿时间,即垃圾收集过程中一次 STW 的最长时间,越短越好,一定程度上可以接受频次的增大,GC 技术的主要发展方向。
- 吞吐量(Throughput): 应用系统的生命周期内,由于 GC 线程会占用 Mutator 当前可用的 CPU 时钟周期,吞吐量即为 Mutator 有效花费的时间占系统总运行时间的百分比,例如系统运行了 100 min,GC 耗时 1 min,则系统吞吐量为 99%,吞吐量优先的收集器可以接受较长的停顿。
基本的调优思路可以总结为:
- 理解应用需求和问题,确定调优目标。假设,我们开发了一个应用服务,但发现偶尔会出现性能抖动,出现较长的服务停顿。评估用户可接受的响应时间和业务量,将目标简化为,希望 GC 暂停尽量控制在 200ms 以内,并且保证一定标准的吞吐量。
- 掌握 JVM 和 GC 的状态,定位具体的问题,确定真的有 GC 调优的必要。具体有很多方法,比如,通过 jstat 等工具查看 GC 等相关状态,可以开启 GC 日志,或者是利用操作系统提供的诊断工具等。例如,通过追踪 GC 日志,就可以查找是不是 GC 在特定时间发生了长时间的暂停,进而导致了应用响应不及时。
- 这里需要思考,选择的 GC 类型是否符合我们的应用特征,如果是,具体问题表现在哪里,是 Minor GC 过长,还是 Mixed GC 等出现异常停顿情况;如果不是,考虑切换到什么类型,如 CMS 和 G1 都是更侧重于低延迟的 GC 选项。
- 通过分析确定具体调整的参数或者软硬件配置。
- 验证是否达到调优目标,如果达到目标,即可以考虑结束调优;否则,重复完成分析、调整、验证这个过程。
思路: 可以说一下jps,top ,jstack这几个命令,再配合一次排查线上问题进行解答。
我的答案:
- 输入jps,获得进程号。
- top -Hp pid 获取本进程中所有线程的CPU耗时性能
- jstack pid命令查看当前java进程的堆栈状态
- 或者 jstack -l > /tmp/output.txt 把堆栈信息打到一个txt文件。
- 可以使用 fastthread 堆栈定位,fastthread.io/
java -XX:+PrintCommandLineFlags -version使用 G1 垃圾收集
java -XX:+UseG1GC -jar yourapp.jar垃圾收集器是JVM用来自动管理内存的重要组成部分。它们的主要任务是识别和回收不再使用的对象,释放内存资源。以下是对垃圾收集器的一些关键理解:
- 自动化内存管理:自动化内存管理减少了内存泄漏和野指针的风险。
- 性能影响:不同的垃圾收集器对应用程序性能的影响不同。选择合适的垃圾收集器可以显著提高应用程序性能。
- 算法多样性:存在多种垃圾收集算法,每种算法都有其特定的使用场景和优缺点。
- 与应用程序特性匹配:选择垃圾收集器时,需要考虑应用程序的特性,如对象生命周期、响应时间要求、吞吐量需求等。
- 资源消耗:垃圾收集器可能会消耗额外的CPU资源来执行垃圾回收任务。
- 内存分配策略:垃圾收集器通常与特定的内存分配策略(如TLAB)结合使用,以优化内存分配性能。
- 并发与增量收集:现代垃圾收集器通常支持并发或增量收集,以减少GC引起的应用程序停顿。
- 可配置性:大多数垃圾收集器都可以通过JVM参数进行配置,以适应不同的性能需求。
- 持续发展:垃圾收集器和算法随着JVM的更新而不断发展,新的垃圾收集器(如ZGC、Shenandoah等)提供了更低的延迟和更好的性能。
通过合理选择和配置垃圾收集器,可以显著提高Java应用程序的性能和稳定性。
- 初步排查
- 确认问题:确认问题的存在和范围。检查是否所有服务变慢还是只有特定的服务。
- 收集信息:从用户反馈、日志、监控系统中收集详细的症状描述和时间信息。
- 硬件资源检查
- CPU 使用率:检查 CPU 使用率是否过高,是否存在 CPU 瓶颈。
- 内存使用:检查内存使用情况,是否存在内存泄漏或不合理的内存占用。
- 磁盘 I/O:检查磁盘 I/O 是否成为瓶颈,是否有大量的读写操作。
- 网络流量:检查网络带宽和延迟,是否存在网络瓶颈。
- 系统级别检查
- 系统日志:查看操作系统日志(如
/var/log/syslog或/var/log/messages),检查是否有硬件故障、驱动问题等。 - 资源使用:使用
top、htop、vmstat、iostat等工具查看实时资源使用情况。 - 进程检查:查看是否有异常进程占用大量资源。
- 系统日志:查看操作系统日志(如
- 应用级别检查
- 应用日志:检查应用日志,查看是否有异常错误、超时或其他提示信息。
- 线程和堆栈:检查应用的线程和堆栈信息,使用工具如
jstack查看 Java 应用的线程状态。 - 垃圾回收:如果是 Java 应用,检查垃圾回收日志,查看是否存在频繁的 GC 停顿。
- 数据库性能:检查数据库性能,查看是否存在慢查询、大量锁等待等问题。
- 网络检查
- 网络延迟:使用
ping、traceroute等工具检查网络延迟和路径。 - 带宽占用:使用
iftop、netstat等工具查看网络带宽占用情况。
- 网络延迟:使用
- 外部依赖
- 第三方服务:检查依赖的第三方服务是否正常运行,是否存在响应缓慢的问题。
- API 调用:检查外部 API 调用的响应时间,是否存在延迟。
- 基准测试
- 负载测试:使用工具如
JMeter、Gatling对应用进行负载测试,评估其在高负载下的表现。 - 压力测试:模拟高并发用户访问,评估应用的最大承载能力。
- 负载测试:使用工具如
- 性能监控
- 监控工具:使用监控工具如 Prometheus、Grafana、Nagios、Zabbix 等,对服务器的 CPU、内存、磁盘 I/O、网络等进行持续监控。
- 应用性能监控:使用 APM 工具如 New Relic、AppDynamics、Dynatrace 等,监控应用的性能指标,如响应时间、错误率、吞吐量等。
- 日志分析
- 集中日志管理:使用 ELK(Elasticsearch, Logstash, Kibana)或 Splunk 等工具集中管理和分析日志。
- 日志分析:分析应用日志和系统日志,查找异常和错误信息。
- 性能优化
- 代码优化:分析应用代码,查找性能瓶颈,如低效算法、频繁的 I/O 操作等。
- 数据库优化:优化数据库查询,添加索引、优化 SQL 语句、调整数据库配置等。
- 缓存策略:使用缓存(如 Redis、Memcached)减轻数据库压力,提升响应速度。
- 负载均衡:使用负载均衡(如 Nginx、HAProxy)分发流量,减轻单点压力。
- 集群和分布式:将应用部署在集群或分布式环境中,提高系统的扩展性和可靠性。
诊断服务器变慢需要系统的方法,从硬件资源、系统级别、应用级别、网络和外部依赖等多个方面进行排查。性能评估则需要通过基准测试、性能监控、日志分析等手段全面了解系统性能,并通过优化代码、数据库、缓存策略等措施提升系统性能。定期的性能评估和优化可以帮助维护系统的稳定性和高效性。
生产环境出现 CPU 占用过高的情况可能影响应用的性能和响应速度。下面是详细的分析思路和定位步骤:
分析思路和定位步骤
-
确认问题
- 监控系统:检查监控系统(如 Prometheus、Grafana)上的 CPU 使用率图表,确认 CPU 使用率过高的时间段和趋势。
- 范围确认:确定是单个服务器还是整个集群的 CPU 占用都很高。
-
检查操作系统和硬件资源
-
系统日志:查看操作系统日志(如
/var/log/syslog或/var/log/messages),检查是否有硬件故障、驱动问题等。 -
资源使用工具:使用
top、htop、vmstat、iostat等工具实时查看 CPU 使用情况,识别占用 CPU 最高的进程。 -
进程检查:使用
ps命令列出所有进程及其 CPU 使用情况,例如:ps aux --sort=-%cpu
-
-
应用层面分析
- 应用日志:检查应用日志,查看是否有异常错误、超时或其他提示信息。
- 线程分析:如果是 Java 应用,使用
jstack或其他线程分析工具生成线程堆栈信息,查看哪些线程在占用大量 CPU。 - 热点分析:使用
perf、flame graph(火焰图)等性能分析工具进行热点分析,查看具体哪些代码或方法在消耗 CPU。
-
数据库和外部服务
- 数据库性能:检查数据库性能,查看是否有慢查询、大量锁等待等问题。使用工具如
slow query log、explain分析 SQL 语句。 - 外部依赖:检查依赖的第三方服务或 API 调用是否存在性能问题,导致应用在等待响应时占用 CPU。
- 数据库性能:检查数据库性能,查看是否有慢查询、大量锁等待等问题。使用工具如
-
内存和垃圾回收
-
内存使用:检查内存使用情况,是否有内存泄漏导致频繁的垃圾回收。
-
垃圾回收日志:如果是 Java 应用,检查垃圾回收日志,查看是否存在频繁的 Full GC。使用
jstat工具查看 GC 活动:jstat -gcutil <pid> 1000
-
-
代码和配置优化
- 代码检查:检查代码是否存在效率低下的算法或循环,特别是高频调用的部分。
- 配置调整:调整应用和服务器的配置,例如线程池大小、数据库连接池配置等,以优化性能。
具体步骤和工具示例
-
使用
top或htop查看 CPU 使用情况top
观察哪个进程占用 CPU 最高,记下 PID。
-
使用
ps查看详细进程信息ps aux --sort=-%cpu | head -n 10查看占用 CPU 前 10 的进程。
-
生成线程堆栈信息(针对 Java 应用)
jstack <pid> > thread_dump.txt
分析
thread_dump.txt文件,查看哪些线程在占用大量 CPU。 -
使用
perf工具进行性能分析perf record -F 99 -p <pid> -g -- sleep 30 perf script > out.perf
然后使用
FlameGraph工具生成火焰图,分析热点代码。 -
检查和调整垃圾回收配置 查看垃圾回收日志,分析是否有频繁的 Full GC,可以尝试调整堆大小或更换垃圾回收器。
通过上述步骤,可以系统地分析和定位生产环境中 CPU 占用过高的问题。首先确认问题范围,然后检查系统和应用层面,使用合适的工具和方法进行深入分析,最终根据分析结果进行代码和配置优化。定期的性能监控和分析可以预防和及时解决类似问题,保证系统的稳定运行。
对于JDK 自带的JVM 监控和性能分析工具用过哪些?你是怎么用的?
1、JMX(Java Management Extensions):
-
JMX是Java平台的内置管理框架,用于监控和管理Java应用程序。通过JMX,可以获取JVM的运行时数据,包括内存使用情况、线程信息、垃圾回收统计等。
使用 JConsole 监控 JVM
- 启动 JConsole:
- JConsole 是 JDK 自带的图形化工具,用于监控 JVM 的各种指标。
- 你可以在命令行中输入
jconsole启动 JConsole。
- 连接到 JVM:
- 在 JConsole 的连接窗口中选择本地进程或远程进程,然后点击连接。
- 查看性能指标:
- 在 JConsole 中,你可以查看内存使用情况、线程活动、类加载、MBean 等
也可以通过编程方式使用 JMX 访问 JVM 的性能指标
public class JMXExample {
    public static void main(String[] args) throws Exception {
        MBeanServerConnection mBeanServer = ManagementFactory.getPlatformMBeanServer();
        ObjectName memoryMXBeanName = new ObjectName(ManagementFactory.MEMORY_MXBEAN_NAME);
        MemoryMXBean memoryMXBean = ManagementFactory.newPlatformMXBeanProxy(mBeanServer, memoryMXBeanName.toString(), MemoryMXBean.class);

        // 获取堆内存使用情况
        MemoryUsage heapMemoryUsage = memoryMXBean.getHeapMemoryUsage();
        System.out.println("Heap Memory Usage: " + heapMemoryUsage);

        // 获取非堆内存使用情况
        MemoryUsage nonHeapMemoryUsage = memoryMXBean.getNonHeapMemoryUsage();
        System.out.println("Non-Heap Memory Usage: " + nonHeapMemoryUsage);
    }
}
- 启动 JConsole:
-
可以使用JMX Exporter将JVM的监控指标暴露给Prometheus进行采集和监控
2、使用 Java 命令行工具
jstat是一个命令行工具,用于监控 JVM 的各种性能指标,如垃圾回收、类加载等jmap用于生成堆转储文件(heap dump)和查看堆内存的详细信息jstack用于生成线程快照(thread dump),可以帮助诊断线程死锁和高 CPU 使用问题
3、使用第三方监控工具
-
VisualVM 是一个强大的图形化工具,用于监控和分析 JVM 的性能。它可以监控内存使用情况、线程活动、垃圾回收等
-
Prometheus 是一个开源监控系统,Grafana 是一个开源的时序数据可视化工具。结合使用这两个工具可以实现对 JVM 的高级监控和可视化。
4、使用 Spring Boot Actuator (如果使用 Spring Boot)